来源:HPG 2026 论文《Ray Tracing Massive Amounts of Animated Geometry》(Gruen、Benthin、Kern、McAllister)作者版全文,及 GPUOpen 配套技术文章
面向读者:图形程序员
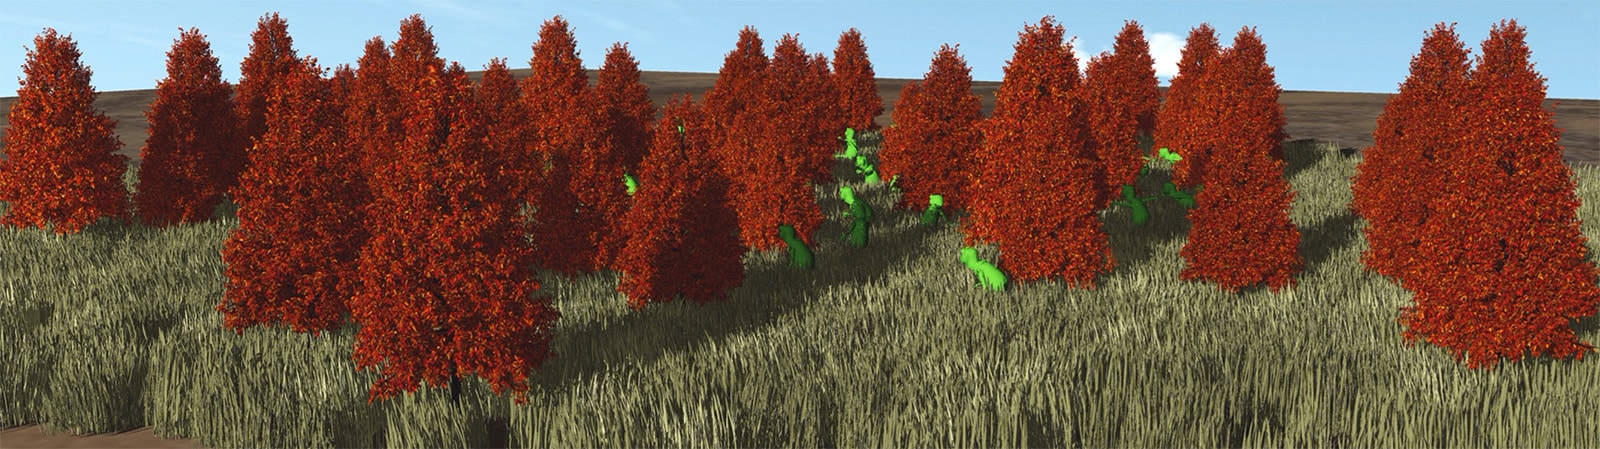
图 1:树、草和角色混合的测试场景。论文报告约 5.85 亿个独立动画三角形在 RX 9070 XT 上以 1080p 跑到 60 FPS,主射线加阴影射线各一条。
目录
一、问题:每帧预算被三角形密度吃掉
常规光追里,一个独立变形的物体每帧要走三步:算出动画后的高模顶点、更新或重建覆盖这些三角形的 BLAS、再更新 TLAS。三步的成本都跟着三角形密度走。
真正难受的是同一资产的多个副本各自摇动。它们的三角形位置各不相同,没法像刚体实例那样共享一个 BLAS,于是每个副本都得自己存一份动态几何和一份 BVH。副本数一上去,显存和更新时间都是线性爬升。
论文换掉的不是动画算法,而是光追所使用的动画几何表示:让少量四面体顶点驱动形变,密集三角形仍然参与最终求交,但不再逐帧显式生成它们的新位置。省下来的是高模顶点动画、逐副本高模 BLAS 状态及其更新;上层结构该更新还是要更新。
“把形变变换施加到几何的非动画姿态上”这个核心思路,论文明确说是承袭 Luton 和 Tricard 在 HPG 2025 上用四面体笼光栅化无网格表示的工作,这篇论文的贡献是把它扩展到实时光追领域。
二、核心思路:动的是笼子和射线
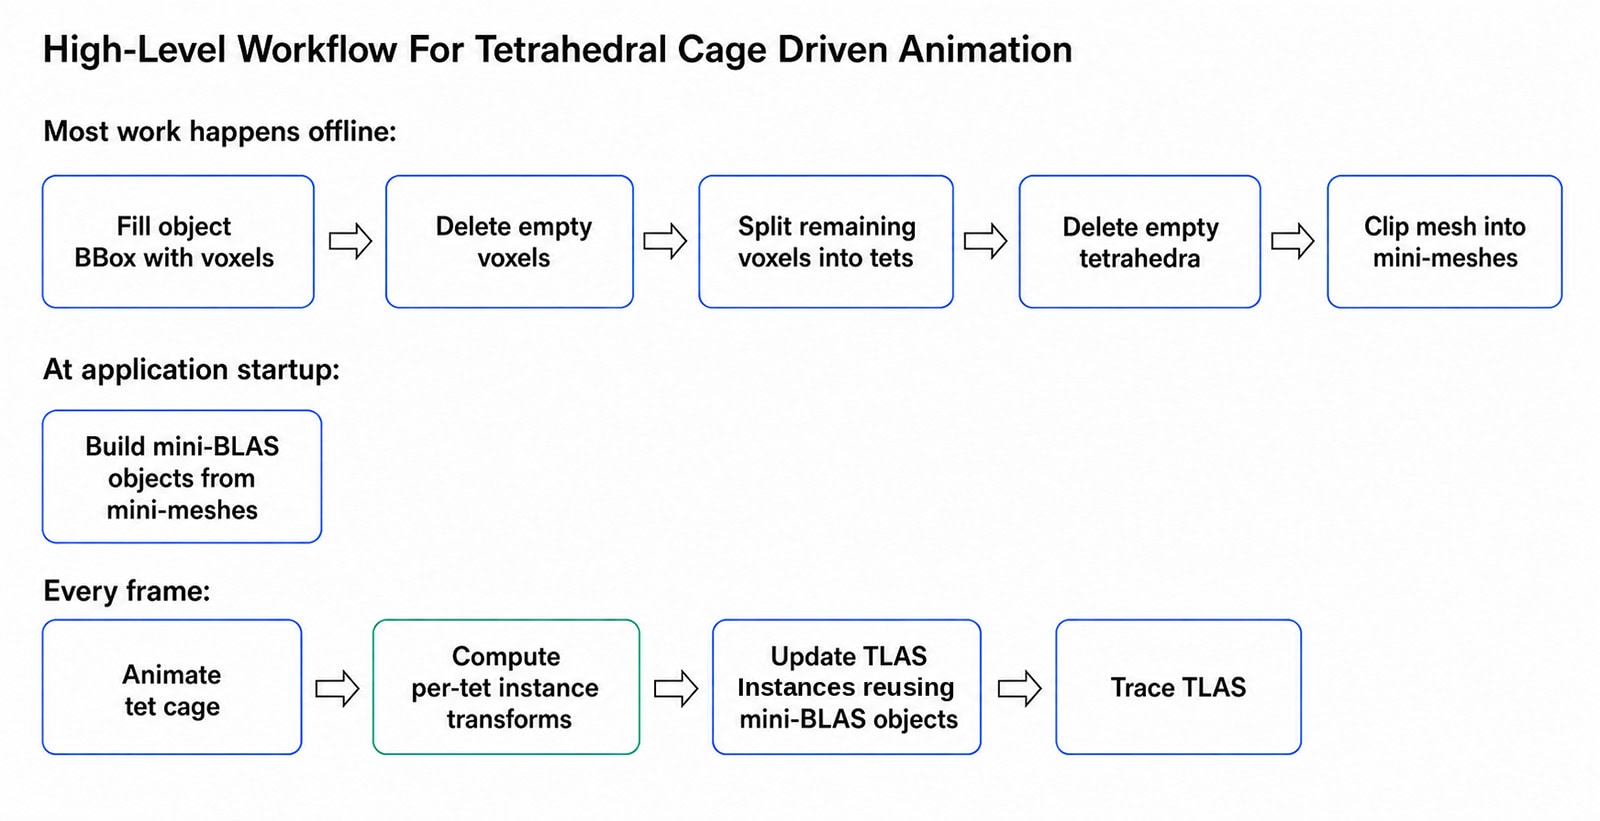
图 2:高层流程。体素化、四面体划分、网格裁切都在离线完成;启动时建一次局部 BLAS;每帧只做笼子动画、实例变换和 TLAS 更新。
两个容易先入为主的误解,先排掉:
四面体笼不是套在 BLAS 外面的一层薄壳。 它是一组覆盖几何的体积单元,同时承担空间划分和形变控制两个职责。每个四面体的四个角决定该单元内部的仿射形变,笼子越细越贴近原动画,但每帧要处理的单元也越多。
论文不是”切四面体”,而是沿四面体边界裁切原三角形。 跨越多个单元的三角形被裁成分属各单元的片段。
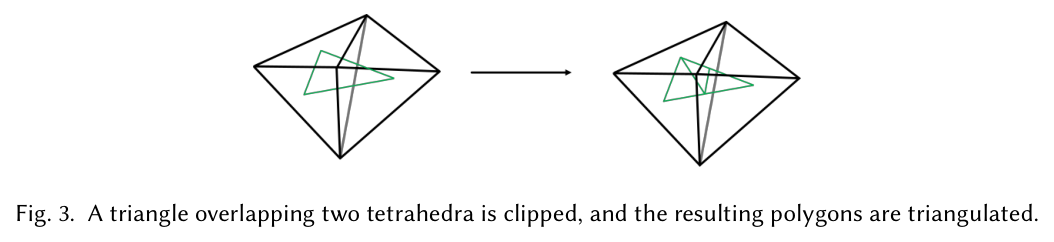
图 3:跨越两个四面体的三角形沿边界被裁开,所得多边形再三角化(论文 Fig. 3)。
裁切不是可选优化,是两个硬约束逼出来的。其一,一个跨单元三角形不可能整体接受两个不同的四面体变换,切开后每个片段才有确定的形变归属。其二,片段必须落在所属四面体内部,上层的空间筛选才成立。相邻单元边界上新产生的顶点会做去重与共享。
代价是静态几何量上涨:测试资产的三角形数变为原来的约 1.3–2.3 倍,顶点数约 1.4–3.7 倍。这笔开销一次性付清,多个独立动画副本共享同一份裁切结果,副本越多摊得越薄。
三、预处理:裁切与两级结构的建立
从静止姿态出发,四步建出笼子:
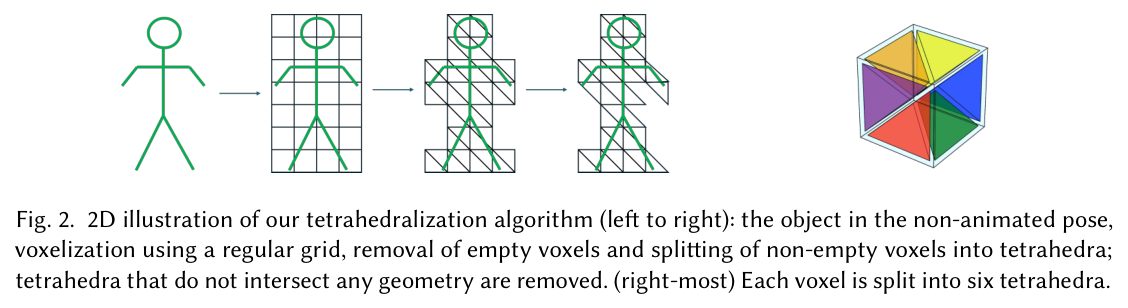
图 4:笼子构造的 2D 示意(论文 Fig. 2)。从左到右:静止姿态的物体、规则网格体素化、删空体素并把每个体素拆成六个四面体、删除不与几何相交的四面体。
- 用规则网格划分包围盒,删除空体素;剩余体素各拆成六个四面体,再删掉不与原网格相交的那些。
- 用每个四面体的四个面裁切与之相交的原三角形,落在该单元内的全部片段组成一个
μMesh。 - 为每个非空
μMesh建一个μBLAS。它就是普通的三角形 BLAS,只是覆盖范围小;保存的是静止姿态下这一局部网格的加速结构,供射线做精细求交。它既不是四面体外壳的 BLAS,也不是原始整物体的 BLAS。既然建完就永不修改,论文顺带点出这里可以套用针对静态 BLAS 的优化,比如 compaction。 - 全部四面体组成上层结构
tetLAS,叶子层是四面体,每个四面体指向自己的μBLAS。
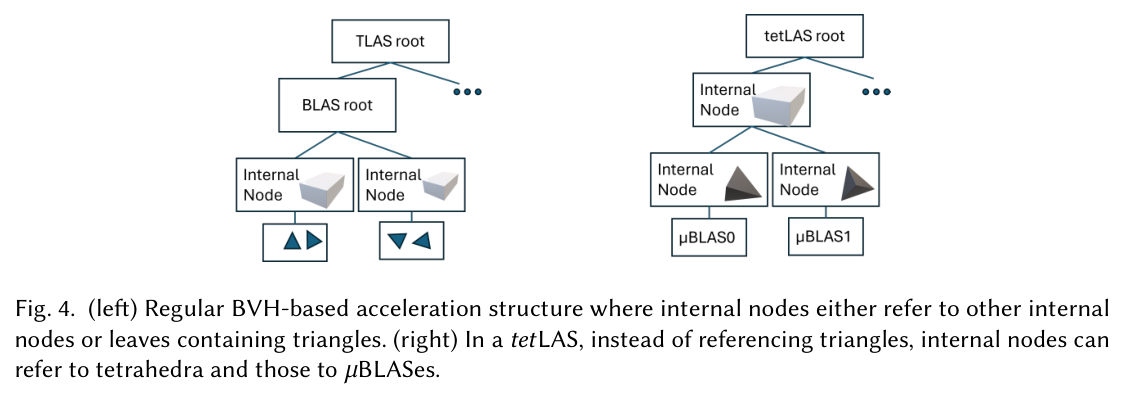
图 5:常规 BVH 的叶子是三角形;tetLAS 的内部节点指向四面体,四面体再指向各自的 μBLAS(论文 Fig. 4)。
μMesh 和 μBLAS 建一次之后保持静态。同一资产的所有独立动画副本共用这一批 μBLAS,各自只持有一份笼子状态(论文称 tetAnimCopy)。
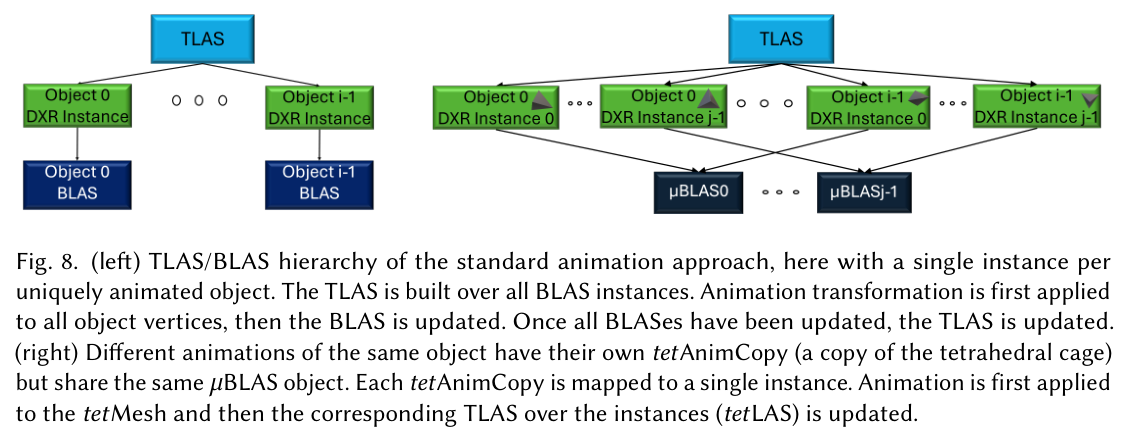
图 6:两种层级结构的对比(论文 Fig. 8)。左:常规做法,每个独立动画物体有自己的 BLAS,动画作用于全部物体顶点,再依次更新 BLAS 与 TLAS。右:各副本各有自己的 tetAnimCopy,共用同一批 μBLAS;动画先作用于 tetMesh,再更新覆盖这些实例的 tetLAS。
四、每帧执行路径
compute shader #1 : 动画笼子顶点(程序化形变 / 骨骼蒙皮)
compute shader #2 : 逐四面体求局部仿射矩阵 → 写 DXR 实例变换
        ↓
重建 TLAS(μBLAS 一律不动)
        ↓
TraceRay → 命中四面体实例 → 硬件逆变换射线 → 遍历静态 μBLAS
三点值得单独拎出来。
骨骼数据怎么落到笼子顶点上。 论文的做法是:为每个笼子顶点在原始模型上找最近顶点,继承它的骨骼 ID 与权重;裁切时骨骼数据像普通顶点属性一样插值,每个三角形最多收集 12 个骨骼 ID,裁切完成后按权重排序、只保留最大的四个并归一化。⚠️ 这只是对原始蒙皮的近似,质量直接取决于笼子分辨率。
实例矩阵在 GPU 上算。 第二个 compute shader 读动画后的笼子顶点,逐四面体求出局部仿射变换。这一步的规模跟四面体数走,不跟三角形数走。
TLAS 每帧重建,μBLAS 一次不更新。 论文的 DXR 实验实现就是这么做的。不同动画副本之间的差异全部体现在笼子状态和对应的上层实例状态里,没有任何一个副本需要保存一套动画后的高模 BLAS。
五、射线为什么可以代替三角形移动
设某四面体静止时四角为 v₀…v₃,动画后为 a₀…a₃。内部一点静止时写成 p = Σᵢ bᵢvᵢ,动画后就是 p′ = Σᵢ bᵢaᵢ —— 重心权重 bᵢ 不变。所以单元内部所有三角形片段共用同一个由四角决定的仿射变换。
对于这种笼子诱导的分块仿射几何,逆变换射线再与静态三角形求交,等价于先变换三角形再用原射线求交。
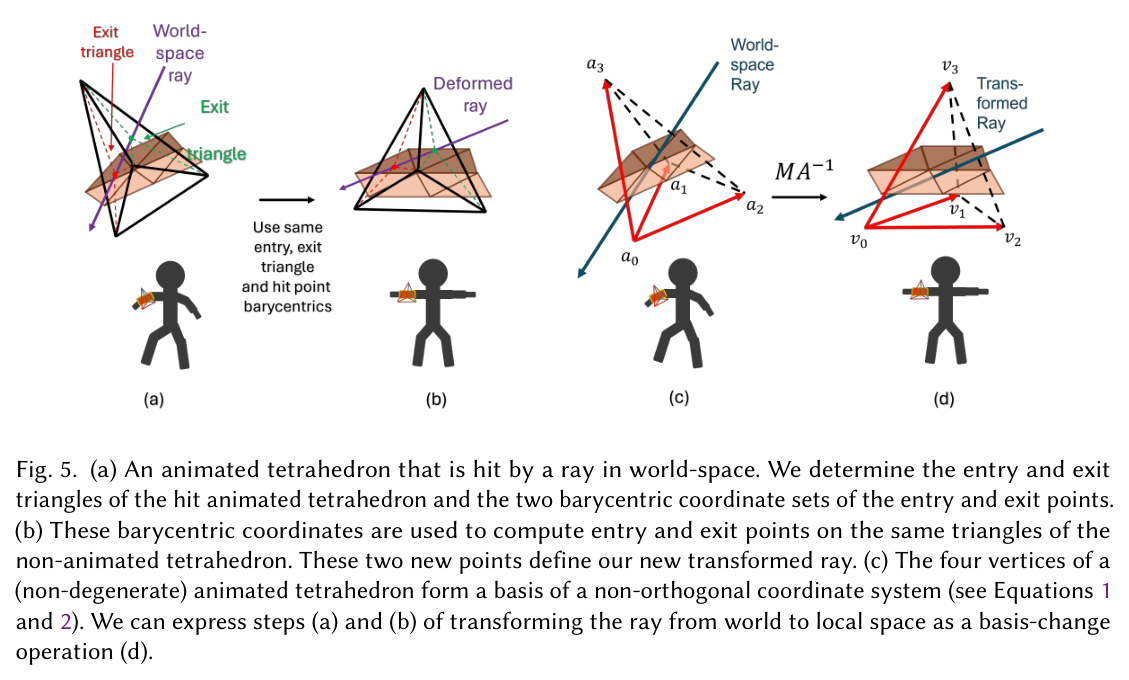
图 7:射线变换的四步(论文 Fig. 5)。(a) 世界空间射线命中动画后的四面体,取 entry/exit 面与两个交点的重心坐标;(b) 用同一组重心坐标在静止四面体的同一批面上求出两个新交点,这两点定义”变换后的射线”;(c)→(d) 整个过程等价于一次基变换,即矩阵 MA⁻¹。注意 (d) 里射线打向的是静止姿态的四面体与几何 —— 动的始终是射线。
论文把这个变换写成了显式矩阵(Eq. 1、Eq. 2):
M(3×3):静止四面体的三条基向量v₁−v₀、v₂−v₀、v₃−v₀;A(3×4):动画四面体的三条基向量加平移列a₁−a₀、a₂−a₀、a₃−a₀、a₀;- 交给 DXR 的 3×4 实例变换为
A · (M⁻¹)₃ₓ₄,其中(M⁻¹)₃ₓ₄是把M⁻¹扩成 3×4、第四列补零。(M⁻¹)₃ₓ₄全程静态,可以在预处理阶段一次性算完。
❓ 论文 §6 把这个乘积记作”combined matrix Oᵢ Aᵢ (Mᵢ⁻¹)₃ₓ₄”,但 O 在全文没有任何定义式,而 §4.1 给出的实例变换就是 A(M⁻¹)₃ₓ₄。照着实现时以 §4.1 为准。
预处理时每个 μMesh 的顶点会先减去 v₀,矩阵作用在这些相对坐标上正好得到动画后的世界空间位置;相对坐标数值更小,对浮点精度也更友好。图 7 里标的 MA⁻¹ 就是硬件在遍历局部 BLAS 前实际施加在射线上的那个逆矩阵。
成立前提有两条,都要在预处理阶段保证:静止四面体非退化,实例变换可逆。
❗ 这不是让动画成本凭空消失。每帧仍要算笼子顶点、实例矩阵和上层加速结构,省掉的是逐个算出高模顶点新位置、以及据此更新所有局部 BLAS。而且这种形变对原始逐顶点动画本身就是近似,不是对任意动画都等价。
⚠️ 若同一资产仍走传统光栅化路径,光栅化阶段多半还是要算高模顶点;论文直接降低的是光追几何表示及其加速结构的更新成本,不能据此断言整个混合渲染器都不再处理原始顶点。
成本规模对照
| 每帧环节 | 常规独立变形网格 | 四面体笼方案 |
|---|---|---|
| 顶点动画 | 处理高模顶点,规模随其顶点数增长 | 处理笼子顶点,规模随笼子分辨率增长 |
| 加速结构 | 更新每个副本的高模 BLAS,再更新 TLAS | 复用静态 μBLAS,更新四面体实例及 TLAS |
| 多副本几何状态 | 各副本自带动态高模几何和 BVH 状态 | 共享裁切后的静态几何和 μBLAS,各副本只存笼子 |
这张表说的是工作量由什么决定,不是在断言 TLAS 构建有固定的渐近复杂度 —— 实际耗时还受四面体数量、API 实现和射线分布影响。
六、两种求交实现与接缝精度
| 方案 | DXR 中的做法 | 主要收益 | 主要代价 |
|---|---|---|---|
| 硬件实例变换版 | 每个四面体映射为一个引用静态 μBLAS 的 DXR 实例,由硬件逆变换射线并完成三角形求交 | 全程走硬件 BLAS 遍历,适合实时 | 相邻单元各自变换射线,浮点误差下不能严格保证接缝无裂缝;变换必须可逆 |
| 严格无缝版 | 局部顶点和 BVH 边界表示为相对四面体的四维重心坐标,用 DXR 程序化几何在软件里按需还原世界空间 AABB 与三角形 | 共享边界还原出逐比特一致的世界空间位置,求交结果与从哪一侧进入无关 | DXR 不支持这种四维 BVH,只能软件遍历,渲染耗时高一到两个量级 |
接缝问题的来源很直接:
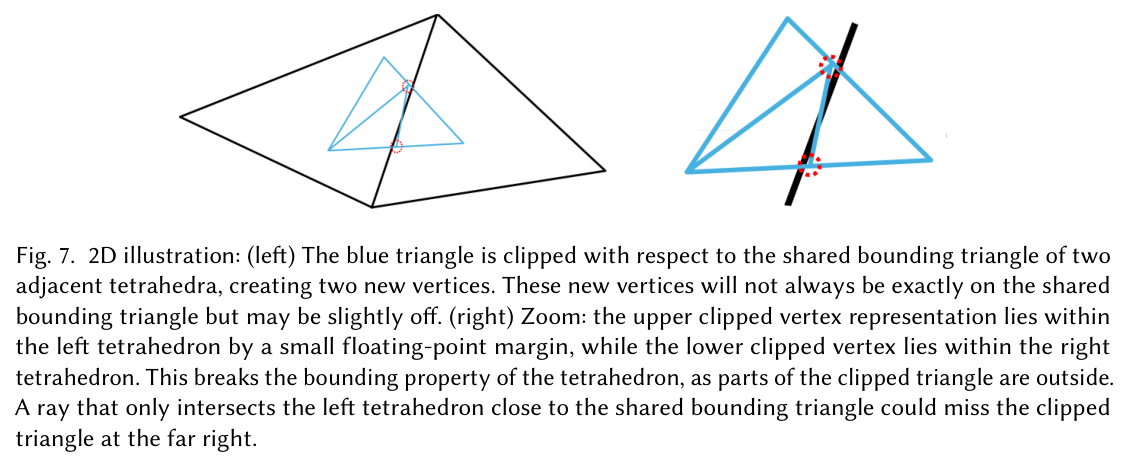
图 8:蓝色三角形被两个相邻四面体的共享面裁切,新顶点不一定精确落在共享面上;浮点误差会让它略微偏向一侧,包围性质随之破坏 —— 只与左侧单元相交的射线可能因此错过远处的片段(论文 Fig. 7)。
快速版的缓解手段是在裁切前把四面体沿四个面的外法线略微外扩,让接缝处的片段互相重叠一点:
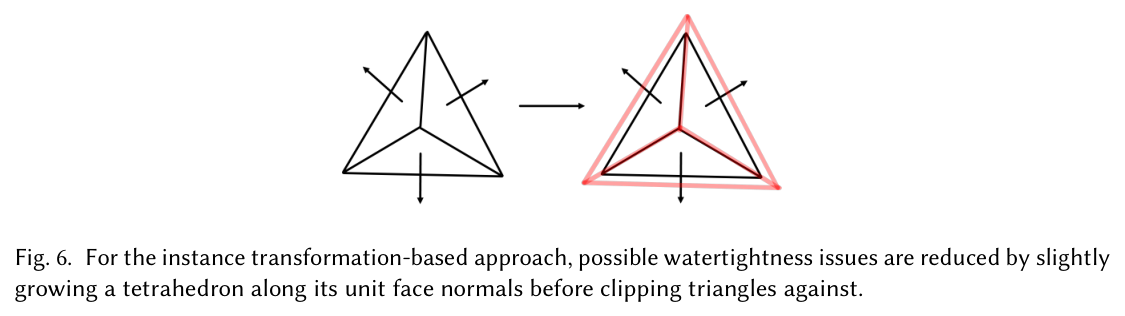
图 9:ε 外扩(论文 Fig. 6)。孤立测试用的是闭合球体(半径 100、约 100 万原始三角形、裁切后约 120 万、9×12×9 笼子),从球心向外打射线:不外扩时约 0.01% 的射线穿过球面逃逸,外扩后归零。
❗ ε 由用户指定且与场景相关,论文测试场景用的 2.5×10⁻⁶ 不是一个可以照抄的通用常数。它要大到足以盖住接缝误差,又要小到不产生可见的重叠渲染瑕疵、不制造过多重复的四面体求交 —— 这个区间得自己标。
外扩是缓解不是保证。严格无缝版换了条路:射线始终留在世界空间,几何和包围盒反过来从四维表示实时还原。它保证无缝靠的是三件事叠起来 ——
- 唯一全局顶点 ID + 固定求值顺序。 裁切后对所有
μMesh顶点去重、各赋一个唯一 ID;每个四面体把自己的四个顶点按 ID 升序排列,此后每次代入重心坐标公式都用这个顺序。同一个共享点无论从哪一侧的四面体还原,浮点运算的次序都完全一致,结果逐比特相同。 - 顶点按位置分类编码。 落在四面体顶点上只有 1 个非零重心坐标,落在棱上 2 个,落在面上 3 个,内部才是 4 个,每类的非零分量和为 1。另有一个用户指定的距离阈值负责把”几乎在棱上”的顶点吸附到棱上再算坐标。
- 4D BVH。 三角形顶点既然是四维重心坐标,包围盒也得是四维的,于是用二叉 BVH 配四维 AABB。遍历时逐节点按当前笼子顶点把四维包围盒还原成三维世界空间 AABB,用 min-sum heuristic 收紧。论文附录 A 证明了这个还原过程恒保包围性 —— 四面体被压扁、翻转甚至缩到零,min/max 逻辑都能自动吃掉符号变化。
两处容易漏掉的细节。法线要分两种情况处理:一般情况用实例变换的逆转置变换着色法线;骨骼动画的测试里,论文是在着色阶段取命中三角形的三个未形变顶点法线、再对它们做一次蒙皮,以此逼近原始蒙皮几何的法线表现。另外,快速版里同一条原始边可能被相邻单元各测一次,射线在边界附近存在重复求交,论文提到可以把共享边唯一归属给某一个四面体来缓解。
七、实验数据
测试环境:Windows 11、AMD Radeon RX 9070 XT(16 GB)、1080p。渲染计时包含每像素一条主射线和一条阴影射线,以及着色与采样。BLAS 用 ALLOW_UPDATE + PREFER_FAST_BUILD 更新,TLAS 用 PREFER_FAST_TRACE 重建。
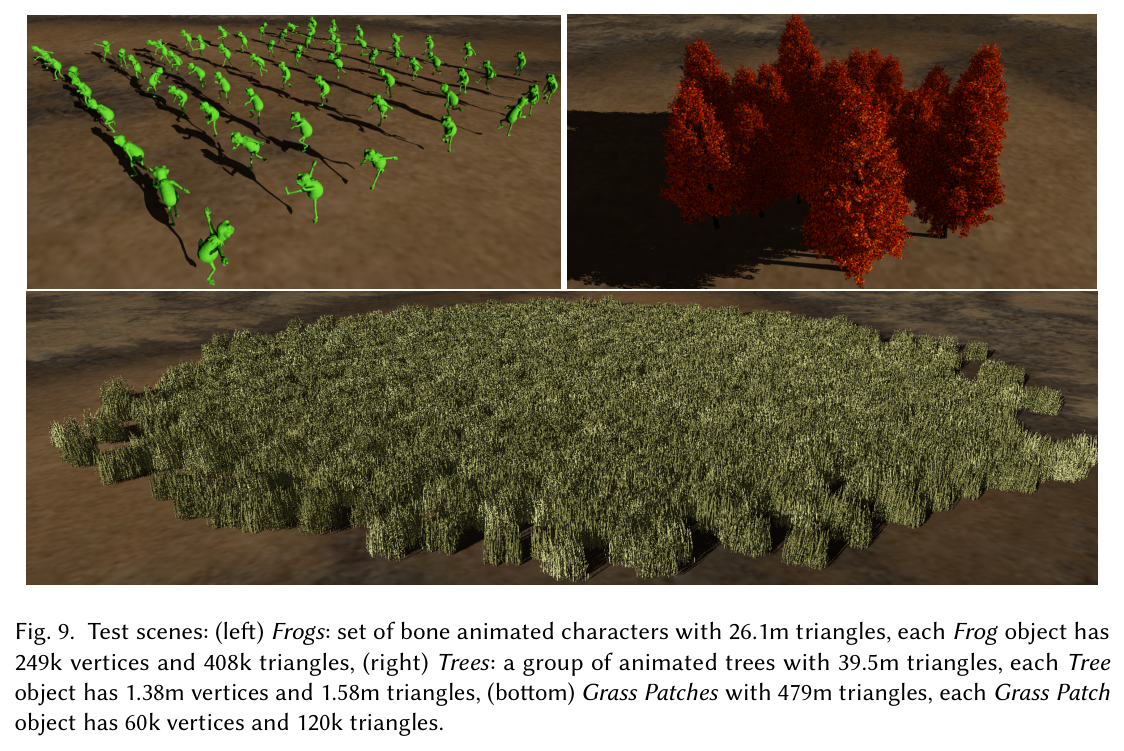
图 10:三个测试场景(论文 Fig. 9)。青蛙:骨骼动画,场景共 2610 万三角形,单体 24.9 万顶点 / 40.8 万三角形;树:场景共 3950 万三角形,单体 138 万顶点 / 158 万三角形;草丛:场景共 4.79 亿三角形,单体 6 万顶点 / 12 万三角形。每个资产复制多份,每份分配一套独立的笼子。
每个资产都测了中、高两档笼子分辨率,沿测试相机路径看不出与逐三角形动画的可见差异 —— 下面这些成本数字是在这个质量前提下取得的。
成本能降下来的根本原因,一张表就说明白了 —— 四面体数比三角形数少两到三个数量级(论文表 1):
| 资产 | 体素分辨率 | 四面体数 | 笼子顶点 | 原三角形 / 顶点 | 裁切后三角形 / 顶点 | 三角形/四面体(均 / 最小 / 最大) |
|---|---|---|---|---|---|---|
| Tree | 5×8×5 | 0.64k | 0.204k | 1.58m / 1.38m | 2.15m(1.36×)/ 1.96m(1.42×) | 3.3k / 1 / 13k |
| Tree | 9×12×9 | 2.32k | 0.639k | 1.58m / 1.38m | 2.55m(1.61×)/ 2.35m(1.70×) | 1.1k / 1 / 4.3k |
| Grass Patch | 6×5×6 | 0.66k | 0.659k | 120k / 60.1k | 207k(1.73×)/ 149k(2.48×) | 0.3k / 1 / 2k |
| Grass Patch | 10×9×10 | 2.42k | 0.722k | 120k / 60.1k | 277k(2.31×)/ 223k(3.70×) | 0.1k / 1 / 0.9k |
| Frog | 15×15×15 | 1.91k | 0.711k | 408k / 249k | 618k(1.51×)/ 418k(1.68×) | 0.3k / 1 / 1.7k |
| Frog | 25×25×25 | 5.55k | 19.24k | 408k / 249k | 761k(1.87×)/ 569k(2.29×) | 0.1k / 1 / 0.8k |
❓ 最后一行的笼子顶点数按论文表 1 原样照录。它与同列其余各行不自洽 —— 5550 个四面体撑不出 19240 个顶点,同资产 15×15×15 档也只有 0.711k,合理值应在 1.9k 量级。
❗ 最后一列的跨度值得盯一眼:最小 1、最大上万。论文的实现不强制每个四面体的三角形预算,一个 μBLAS 装多少完全由笼子分辨率和几何分布决定。规则体素笼罩在不均匀的几何上,必然出现一批近乎空的四面体和少数极重的四面体。
合并场景(论文表 3):
| 原始动画三角形 | 四面体 | 笼子动画 | 加速结构更新 | 射线渲染 | 合计 | GPU 内存 |
|---|---|---|---|---|---|---|
| 约 5.84 亿 | 约 280 万 | 0.35 ms(3%) | 9.66 ms(78%) | 2.42 ms(19%) | 12.43 ms | 770.10 MB |
这一行最强的地方不在 12.43 ms,而在常规方案根本跑不出这个场景 —— 它的 BVH 需求超过了 16 GB 显存上限,压根建不起来,所以这一格没有对照数字可填。
❗ 但也别把它读成”更新成本消失了”。加速结构更新仍占总时间 78%,变的只是更新对象 —— 从密集的逐副本高模 BLAS 换成规模小得多的上层实例。在能跑对照的草丛场景里,相对常规逐顶点动画加 BLAS 更新,快速版总时间最高改善约 9 倍、内存降低约 16.1 倍,而射线渲染本身略慢于常规方案。
真正构成核心证据的是两条曲线的形状:
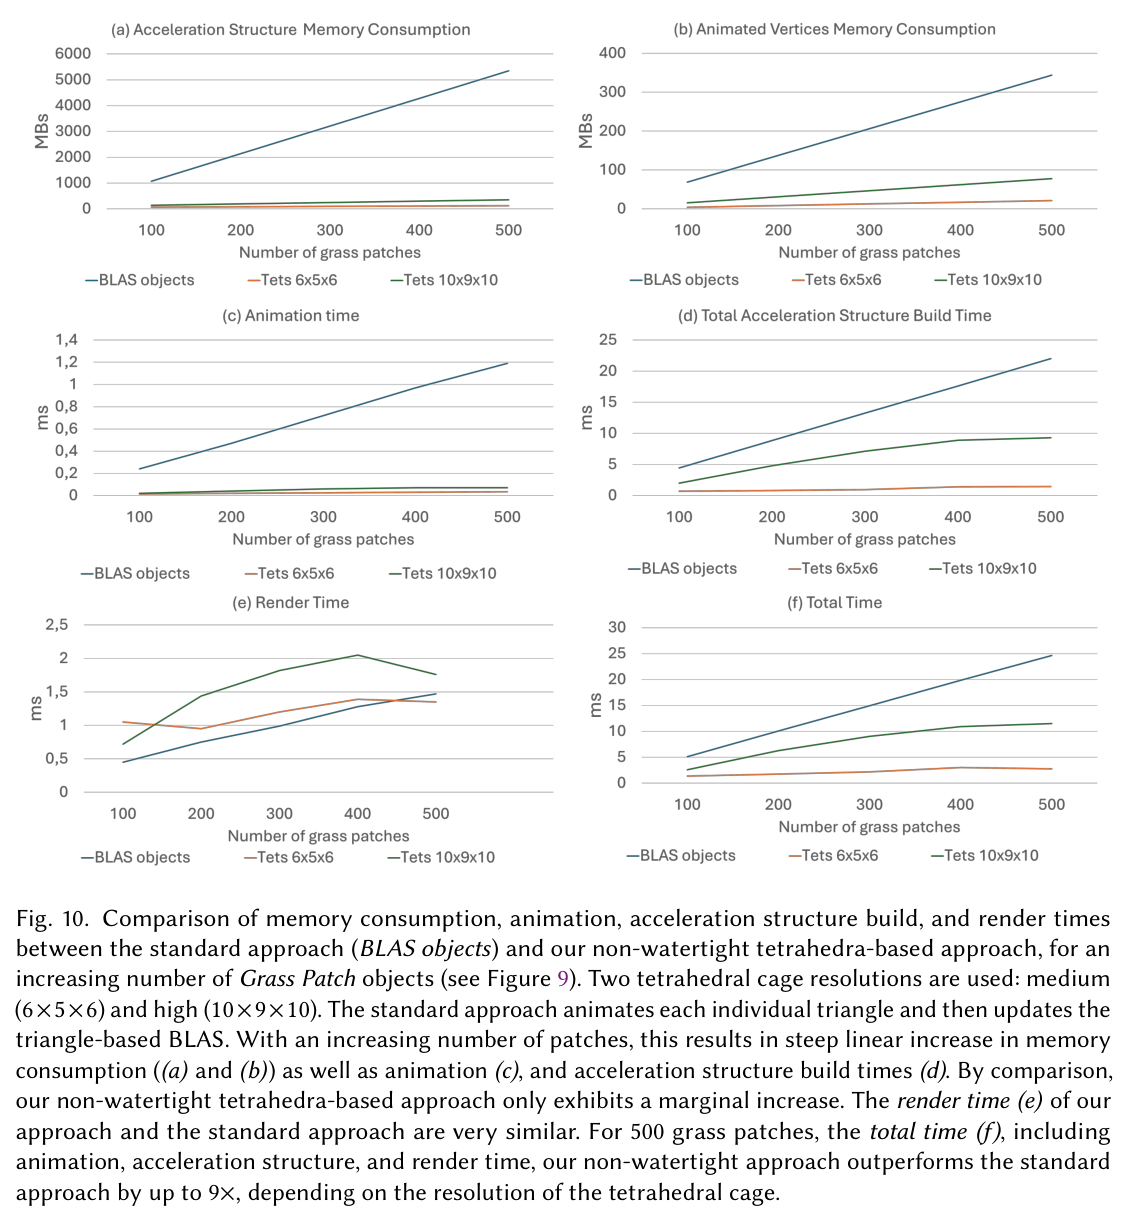
图 11:草丛场景随副本数增长的六个维度(论文 Fig. 10):(a)(b) 显存、(c) 动画时间、(d) 加速结构构建时间、(e) 渲染时间、(f) 总时间。常规方案全面线性增长,笼子方案只有轻微上升;渲染时间 (e) 两者接近,总时间 (f) 在 500 个草丛时相差最高约 9 倍。
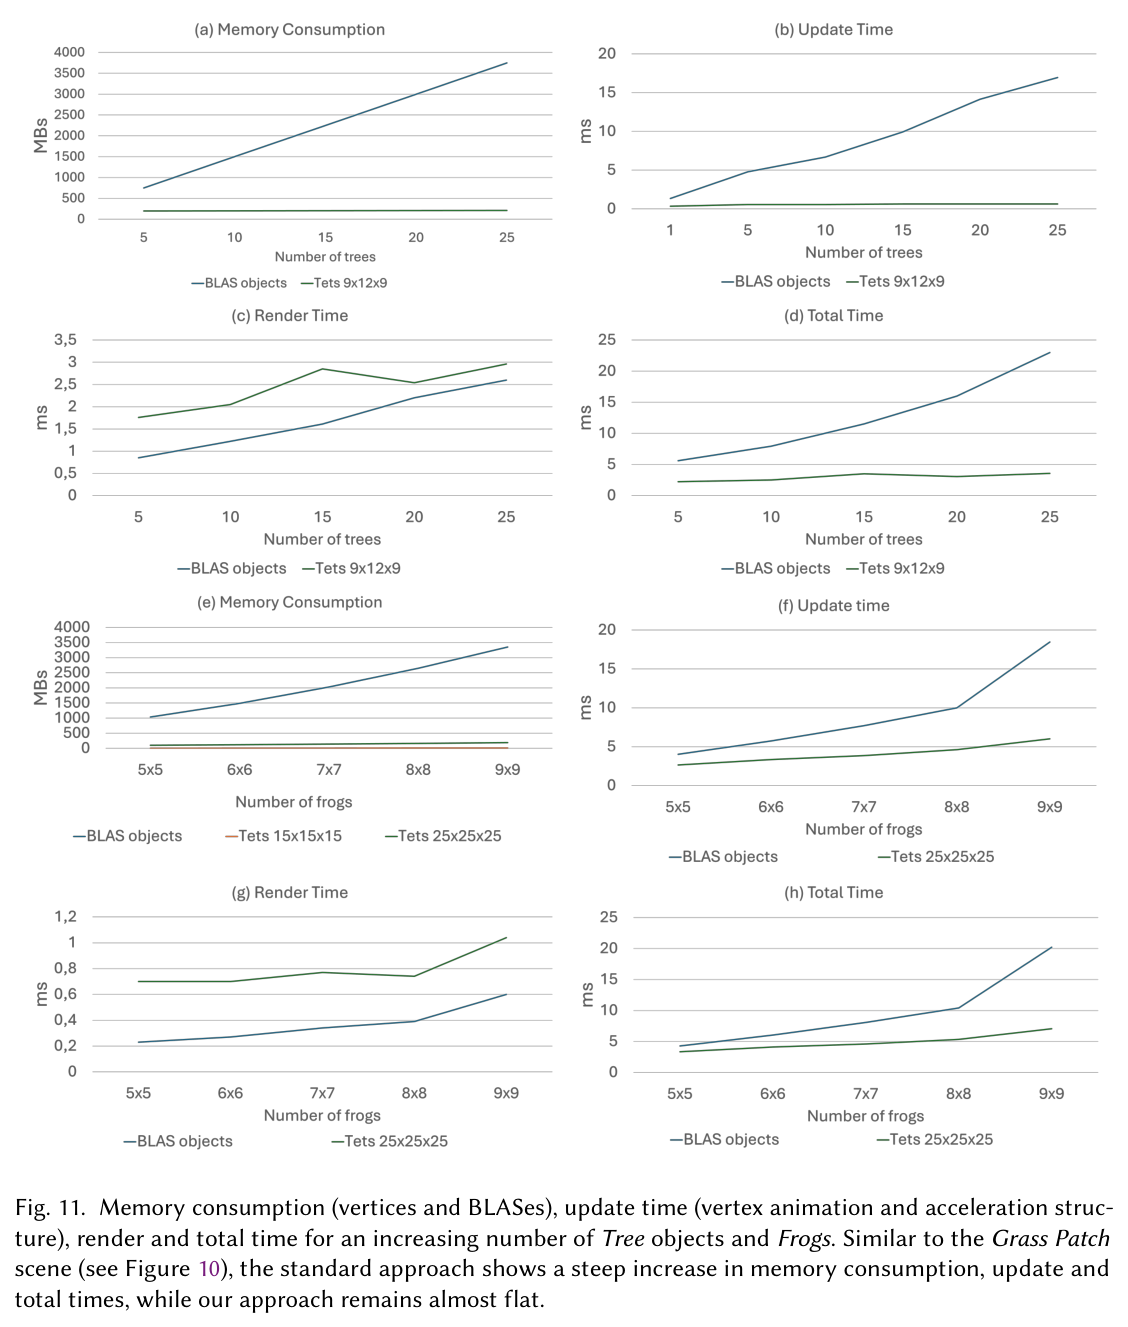
图 12:树与青蛙的对应结果(论文 Fig. 11):(a)–(d) 树(5–25 棵,笼子 9×12×9),(e)–(h) 青蛙(5×5–9×9 只,笼子 25×25×25,其中 (e) 另画了一条 15×15×15 的内存曲线)。
图 12 里最该停一下的是渲染时间 (c)(g):笼子方案高于常规方案,而且在树的场景里从头高到尾。多出来的实例数与遍历开销是实打实的代价,只是被更新阶段的节省盖过去了 —— 看 (d)(h) 的总时间才是笼子方案赢的地方。另外 (e) 里青蛙两种笼子分辨率的内存曲线几乎贴在一起,都紧贴横轴,跟陡升的常规方案不在一个量级上。
两种严格程度的成本差(论文表 2):
| 场景 | 快速版显存 / 渲染 | 严格无缝版显存 / 渲染 | 倍数 |
|---|---|---|---|
| 25 Trees | 209.7 MB / 2.96 ms | 540.5 MB / 203 ms | 2.5× / 68.6× |
| 500 Grass Patches | 145.6 MB / 1.35 ms | 459.4 MB / 108 ms | 3.2× / 80× |
| 81 Frogs(9×9) | 190 MB / 1 ms | 442 MB / 19 ms | 2.3× / 19× |
严格无缝版多吃约 2.3–3.2 倍内存、渲染耗时约 19–80 倍,作者把它定位成正确性参照,而不是当前硬件上的实时方案。
⚠️ 这些倍率受资产密度、笼子分辨率、独立动画副本数、射线分布和硬件影响,不能直接当作自己项目的预期收益。
八、适用边界与工程判断
✅ 这项工作的关键是把”复杂表面怎样动”拆成两个可独立处理的问题:稀疏四面体负责描述运动,静态 μBLAS 负责精确命中真实表面。 每帧的动画和加速结构更新规模因此由笼子分辨率控制,不再直接跟随原网格三角形密度。
三条结论值得记住:
- 四面体笼是体积划分和形变代理,它不替代真实三角形参与最终求交。
μBLAS由每个四面体内裁切后的片段建立一次,多个独立动画副本共享;每帧更新的只有笼子、实例变换和上层结构。- 这是一笔明确的交易:更复杂的预处理、更多静态片段、更高的追踪成本,换来大量独立动画时显著下降的更新与显存成本。
适用范围:拓扑不变、形变较平滑、几何密度高、独立动画副本多。摇摆植被、草地、人群、远景角色、animation LOD 都落在这个区间里。
不适用:拓扑改变(爆炸、破坏、切割)、尺度小于笼子的高频运动(布料褶皱、面部细节)、关节附近权重剧变的复杂角色蒙皮、纯刚体(常规实例化更简单),以及关键帧动画。
最后两类各有出路,不是死路:
- 关键帧动画:需要先算出相邻关键帧之间对应三角形顶点的变换,再把它施加到笼子上,而不是直接插值顶点位置。
- 需要逐三角形控制、或会改变三角形连通性的动画:受影响的
μBLAS必须重建 —— 这一条直接打掉了本方案最核心的收益,所以真遇到就该换路径,而不是硬撑。
笼子分辨率不够时的表现是可预期的:
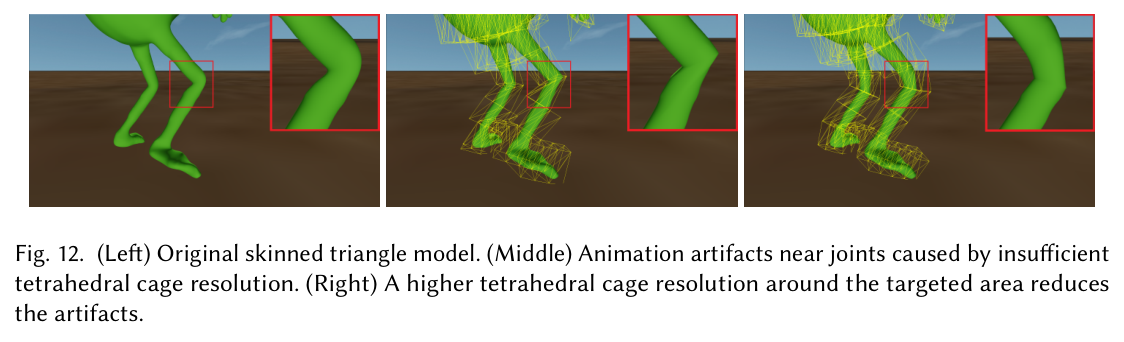
图 13:笼子分辨率不足造成的伪影及局部加密后的改善(论文 Fig. 12)。左:原始蒙皮模型;中:关节附近因笼子太粗出现的形变错误;右:在目标区域提高四面体分辨率后伪影明显减轻。分辨率是连续可调的旋钮,也可以按需局部加密。
作者给出的后续方向:更好的体素→四面体划分算法、用优化方法为笼子挑选骨骼与权重以逼近真实蒙皮、按曲率对高曲率区域递归细分。方法本身可以和 per-object LOD、staggered 更新、cluster 表示以及 partitioned TLAS 组合使用。论文结论里也点明,如果将来有硬件级的四面体图元与 multi-level instancing 支持,射线侧的开销还能再降。
工程上最值得盯的是作者提到的 DXR sample 与 header-only 建笼库(面向 skinned / keyframe / static 物体),那才是这套方案真正可复用的入口。
这篇工作适合用来理解一类重要取舍:光追结构不必逐帧显式存下每个动画后顶点,仍可通过局部坐标变换求交到由控制笼定义的动态几何;同时必须清楚它追踪的是笼子诱导的近似动画,以及快速版的接缝精度边界。
九、参考链接
🔗 GPUOpen - Ray tracing massive amounts of animated geometry using tetrahedral cages
🔗 GPUOpen - How tetrahedral cages significantly reduce BVH memory usage — 后续的大规模地形 demo:约 2.5 万株独立动画植物,BVH 显存从最高 80 GB 降到约 1.7 GB,每帧更新从 300 ms 以上降到约 3.3 ms
🔗 ACM DL - Ray Tracing Massive Amounts of Animated Geometry (10.1145/3820014)
🔗 作者版论文 PDF(GPUOpen 下载)
🔗 HPG 2026 Awards - Wolfgang Straßer Best Paper 第三名
🔗 HPG 2026 现场演讲录像
🔗 Microsoft - DXR Functional Spec, Part 2(partitioned TLAS 等)
🔗 Luton & Tricard, HPG 2025 - Real-time rendering of animated meshless representations — 本方案核心思路的来源,用四面体笼做的是光栅化
🔗 GPUOpen Research Publications