来源:Instance Culling 源码通读 + RenderDoc / 调试器抓帧数据
引擎版本:UE 5.8
面向读者:UE 图形程序员
非 Nanite 几何的实例剔除,在 UE 5.8 里整个搬到了 GPU 上。GPUScene 的实例布局、Load Balancer、跨 pass 合批、CullInstances compute shader、保序压缩、indirect draw,六块拼图串成一条从 FMeshDrawCommand 到顶点着色器三次间接寻址的完整数据流。抓帧里的 264、4618 这类打包值,会在 §6.4 和 §8.5 按位域逐项解开。
目录
- 先看结论
- 为什么要做这件事:三个工程难题
- 全景:一帧里的六个阶段
- 地基:实例数据放在哪里(GPUScene)
- CPU 侧(一):从 MeshDrawCommand 到剔除任务
- CPU 侧(二):Load Balancer
- 跨 pass 合批:Merged Context 与 Deferred Context
- GPU 侧:CullInstances compute shader
- 判定算法细则:IsInstanceVisible
- 保序:Instance Compaction 两阶段
- 结果如何被消费:Indirect Draw 与顶点着色器
- 其它使用者与变体
- 调试与排查
- 设计取舍回顾
- 一页速记
- 参考链接
一、先看结论
范围:走
FMeshDrawCommand的几何——普通静态网格、ISM / HISM、蒙皮网格等。Nanite 有独立的 cluster 剔除管线,但与这里共用同一套FNaniteView剔除视图结构和包围盒剔除函数(§9.2)。
1.1 一句话
传统路径里,“哪些实例要画”和”这些实例的数据怎么喂给 draw call”都是 CPU 的事。GPU Instance Culling 把这两件事都搬到了 GPU 上:
- CPU 只产出一份很小的剔除说明书:这个 pass 里有哪些 draw,每个 draw 对应 GPUScene 里哪几段连续的实例区间;
- GPU 用一个 compute shader 一线程一实例地做可见性判断,幸存实例的
InstanceId被追加写进一块大 buffer(InstanceIdsBuffer),同时把所属 draw 的 indirect args 里的InstanceCount加一; - 绘制阶段用
DrawIndexedIndirect消费这份结果,顶点着色器凭InstanceId回 GPUScene 取变换、包围盒等实例数据。
CPU 始终不知道每个 draw 最后会画多少个实例——这是整套设计的出发点,也是后面所有复杂度(负载均衡、合批、保序)的来源。
1.2 五个角色
| 角色 | 一句话职责 | 主要位置 |
|---|---|---|
| GPUScene | 常驻显存的图元 / 实例数据库,让 GPU”看得见所有实例” | Engine/Source/Runtime/Renderer/Private/GPUScene.h、GPUScene.cpp |
FInstanceCullingContext | 每个 mesh pass 一份的”剔除说明书”:draw 列表 + 实例区间 + 剔除参数 | Engine/Source/Runtime/Renderer/Public/InstanceCulling/InstanceCullingContext.h、Engine/Source/Runtime/Renderer/Private/InstanceCulling/InstanceCullingContext.cpp |
| Load Balancer | 把大小悬殊的实例区间切成”64 线程一组”的工作包 | Engine/Source/Runtime/Renderer/Private/InstanceCulling/InstanceCullingLoadBalancer.h、Engine/Shaders/Private/InstanceCulling/InstanceCullingLoadBalancer.ush |
| Merged / Deferred Context | 把一帧内所有 pass 的说明书合并成很少几次 dispatch | Engine/Source/Runtime/Renderer/Private/InstanceCulling/InstanceCullingMergedContext.*、InstanceCullingManager.*;InstanceCullingContext.cpp 中的 CreateDeferredContext |
CullInstances CS | 逐实例剔除,追加写出可见实例 ID | Engine/Shaders/Private/InstanceCulling/BuildInstanceDrawCommands.usf |
1.3 阅读路线
§2–§3 建立全局图景;§4–§7 是 CPU 侧(数据放哪、任务怎么生成、怎么负载均衡、怎么合批);§8–§10 是 GPU 侧(剔除 shader、判定算法、保序压缩);§11–§14 讲结果如何被消费、其它使用者与变体、排错方法和设计回顾。
二、为什么要做这件事:三个工程难题
2.1 起点:GPUScene 让”GPU 看得见所有实例”
UE5 把图元和实例数据放进常驻显存的 GPUScene(§4)。数据一旦在 GPU 上,“剔除”就不必再由 CPU 完成。FInstanceCullingContext::SetupDrawCommands 里有一句注释点明了这个设计意图(InstanceCullingContext.cpp:1635):
This will cause all instances belonging to the Primitive to be added to the command, if they are visible etc (GPU-Scene knows all - sees all)
CPU 只需告诉 GPU”这个 draw 关联了 GPUScene 里 [Offset, Offset+Count) 这些实例”,其中哪些可见,由 GPU 自己判断。
2.2 三个必须解决的难题
把剔除搬上 GPU 后立刻碰到三个问题,各自对应后面一块主要机制:
| 难题 | 具体表现 | 设计上的回答 |
|---|---|---|
| 输出条数在 CPU 是未知的 | 一个 draw 的可见实例数要等 GPU 算完才知道,而 draw call 必须由 CPU 提前录制 | 每个 draw 预留一条 indirect args,GPU 原子累加 InstanceCount;每个 draw 在 InstanceIdsBuffer 里按”最坏情况(全部可见)“预留输出区间(§5.2、§8.2) |
| 输入规模极不均匀 | 有的图元只有 1 个实例,有的 ISM 有十几万个;“一个 draw 一个线程组”会让小 draw 浪费整个线程组、大 draw 又被单个线程组拖住 | Load Balancer:把所有实例区间切成固定 64 线程一组的工作包,一线程一实例,只有尾部不满才有浪费(§6) |
| 一帧里 pass 太多 | PrePass、BasePass、半透明、每个阴影级联 / 立方体面……每个 pass 各做一次 dispatch,会产生大量很小的 dispatch 与 buffer | Merged / Deferred Context:登记所有 pass 的说明书,在 RDG 执行时合并成寥寥几次 dispatch(§7) |
2.3 隐含约束:不能打翻原有 MDC 体系
MeshDrawCommand(下称 MDC)管线里已经有一整套成熟机制:cached MDC 复用、按 PSO / 材质排序、把相同状态的 MDC 合并成一个实例化 draw(dynamic instancing)、多线程 pass setup……Instance Culling 没有另起炉灶,而是嫁接在这条管线的后半段:SetupDrawCommands 之后,MDC 列表已经排序、合并完毕,此时才为它们分配 indirect args 和剔除工作项。CPU 侧的核心因此是 FInstanceCullingContext::SetupDrawCommands(§5)。
三、全景:一帧里的六个阶段
3.1 流程图
flowchart TB
    subgraph CPU["CPU 并行任务(每个 mesh pass 一份)"]
        A["FMeshDrawCommandPassSetupTask<br/>生成动态 MDC / 排序 / 合并"] --> B["SetupDrawCommands"]
        B --> C["FInstanceCullingContext<br/>IndirectArgs / DrawCommandDescs / InstanceIdOffsets<br/>LoadBalancer items"]
    end
    subgraph RT["渲染线程:RDG 构建期"]
        D["BeginDeferredCulling<br/>声明合并后的 CullInstances pass<br/>(缓冲大小延迟确定)"]
        E["各 pass 调用 BuildRenderingCommands<br/>AddBatch 登记 context"]
    end
    subgraph EXE["RDG Execute"]
        F["首个回调触发 ProcessBatched<br/>MergeBatches 汇总所有 context"]
        G["CullInstances CS<br/>Bin0 UnCulled / Bin1..N Generic"]
        H["Compaction 两阶段<br/>仅保序 draw"]
        I["各 pass 的 DrawIndexedIndirect"]
    end
    C --> E
    D --> F
    E --> F
    F --> G --> H --> I
3.2 六个阶段的时间线
每帧 FDeferredShadingSceneRenderer::Render 一开始就会创建 FRendererViewDataManager 和 FInstanceCullingManager(DeferredShadingRenderer.cpp:2118-2119),生命周期与这一帧的 RDG 一致。前者管理”剔除视图”(§9.2),后者管理”合并后的剔除 pass”和 HZB bin(§7.4),各个 mesh pass 的 setup 与登记都通过它们进行。
| 阶段 | 线程 | 做什么 | 关键函数(文件:行) | 产物 |
|---|---|---|---|---|
| ① Mesh pass setup | 任务线程,每个 pass 一个任务 | 生成动态 MDC → 应用 view 覆盖 → 排序 → SetupDrawCommands | FVisibilityTaskData::SetupMeshPasses(SceneVisibility.cpp:4728)→ FSceneRenderer::SetupMeshPass(SceneRendering.cpp:5010)→ FParallelMeshDrawCommandPass::DispatchPassSetup(MeshDrawCommands.cpp:1373)→ FMeshDrawCommandPassSetupTask(MeshDrawCommands.cpp:1019) | 每个 pass 一个填好数据的 FInstanceCullingContext(纯 CPU 数组) |
| ② GPUScene 就绪 | 渲染线程 | 更新 GPUScene、上传动态图元、注册 culling views | FScene::Update 里的 GPUScene.Update(RendererScene.cpp:6792)、UploadDynamicPrimitiveShaderDataForView(DeferredShadingRenderer.cpp:2245)、FRendererViewDataManager(ViewData.cpp) | GPUScene buffers;FPackedView 数组 |
| ③ 声明合并 pass | 渲染线程(RDG 构建期) | BeginDeferredCulling | FInstanceCullingManager::BeginDeferredCulling(InstanceCullingManager.cpp:99)→ CreateDeferredContext(InstanceCullingContext.cpp:1037) | RDG 中一组”大小待定”的 CullInstances pass 与缓冲 |
| ④ 各 pass 登记 | 渲染线程(RDG 构建期) | PrePass / BasePass / 阴影 / 半透明…… 调 BuildRenderingCommands | FParallelMeshDrawCommandPass::BuildRenderingCommands(MeshDrawCommands.cpp:1643)→ AddBatch(InstanceCullingMergedContext.cpp:162) | 每个 pass 的 FInstanceCullingDrawParams(此时缓冲偏移尚未确定) |
| ⑤ GPU 剔除 | RDG Execute | 首个 RDG 回调触发合并;随后依次:清零 InstanceCount → CullInstances → Compaction | ProcessBatched(InstanceCullingContext.cpp:989)→ MergeBatches(InstanceCullingMergedContext.cpp:30) | InstanceIdsBuffer / DrawIndirectArgsBuffer / InstanceIdOffsetBuffer |
| ⑥ 绘制 | 并行 RHI 命令列表 | 逐 MDC 提交 | FInstanceCullingContext::SubmitDrawCommands(InstanceCullingContext.cpp:1727)→ FMeshDrawCommand::SubmitDrawBegin / SubmitDrawEnd(MeshPassProcessor.cpp:1248 / 1332) | 屏幕像素 |
阶段③除了声明 pass,BeginDeferredCulling 还做两件事(InstanceCullingManager.cpp:99-122):为动态包围盒 buffer 加上对 GPUSkinCache 异步计算的等待;调用 FlushRegisteredViews 把已登记的剔除视图上传到 GPU。GPUScene 里没有实例、没有任何剔除视图、RDG 处于立即模式、或关闭了 r.InstanceCulling.AllowBatchedBuildRenderingCommands 时,函数直接返回,不创建 deferred context。
3.3 为什么剔除能在”一帧开头”批量完成
阶段③发生在 RenderPrePass 之前(DeferredShadingRenderer.cpp:2272 调用 BeginDeferredCulling,PrePass 在 :2467 才开始),剔除 shader 运行时本帧的深度还不存在。它能这么早做,是因为遮挡剔除用的是上一帧的 HZB(§9.5),不依赖本帧深度。
这是整个设计里最关键的时序取舍:牺牲遮挡精度(存在一帧延迟,所以 r.InstanceCulling.OcclusionCull 默认关闭并标为 Preview),换来”所有 pass 的剔除可以在帧首一次性合批完成”。
四、地基:实例数据放在哪里(GPUScene)
4.1 两级数据:Primitive 与 Instance
GPUScene 里有两张主表(外加 payload、lightmap、light 数据等):
- Primitive 表(
GPUScenePrimitiveSceneData):每个图元一条(PRIMITIVE_SCENE_DATA_STRIDE = 44个 float4,SceneDefinitions.h:87)。存放整图元共有的东西:各种 flag(是否有 WPO 关闭距离、是否做 instance 距离剔除……)、距离参数(绘制距离、WPO 关闭距离)、InstanceLocalBounds、WPO 最大位移等; - Instance 表(
GPUSceneInstanceSceneData):每个实例一条。存放该实例的变换、所属图元 ID、实例级 flag 等。
关键约定:一个图元的所有实例在 Instance 表里占据一段连续的槽位。 分配器是 FSpanAllocator InstanceSceneDataAllocator(GPUScene.h:415),入口是 AllocateInstanceSceneDataSlots(PersistentPrimitiveIndex, NumInstanceSceneDataEntries)(GPUScene.h:244)。一个实例的全局槽位号就是它的 InstanceId(24 bit,上限 16,777,216,SceneDefinitions.h:15)。
正是这条约定,让”一个图元的全部实例”可以只用一个二元组 (InstanceDataOffset, NumInstances) 表达——它就是后面剔除工作项(item)的核心内容。
4.2 Instance 数据的布局:tile 内 SoA
每个实例占 3 个 float4(压缩变换)或 4 个 float4(不压缩),见 InstanceUniformShaderParameters.h:74-75。FInstanceSceneShaderData::BuildInternal(InstanceUniformShaderParameters.h:115)的打包方式:
| float4 下标 | 内容 |
|---|---|
[0].x | InstanceFlags << 20 按位或 PrimitiveId:图元 ID 占低 20 bit,实例 flag 占高 12 bit |
[0].y | CustomDataCount << 24 按位或 RelativeId:实例在图元内的编号占低 24 bit,自定义数据个数占高 8 bit |
[0].z | LastUpdateFrame:最近一次被更新的场景帧号,Nanite 据此判断实例本帧是否移动过(NaniteSceneCommon.ush:35) |
[0].w | RandomID:每实例随机数 |
[1]、[2](、[3]) | 变换:压缩格式(旋转 + 缩放 + 平移)占 [1][2];不压缩格式是 3×4 矩阵的三行 |
零缩放(RotDeterminant == 0)或被调用方标记为不可见的实例,构建时会被直接打上 INSTANCE_SCENE_DATA_FLAG_HIDDEN。剔除时靠 ValidInstance(PrimitiveId 合法且未隐藏,SceneData.ush:1123)把它们一并丢掉。
存储顺序不是”一个实例接一个实例”,而是 tile 内按 SoA 排列。shader 里的寻址函数(SceneData.ush:670):
uint CalcInstanceDataIndex(uint InstanceId, uint ArrayIndex)
{
	FSceneData SceneData = GetSceneData();
	uint TileId = InstanceId >> SceneData.InstanceDataTileSizeLog2;
	uint IdInTile = InstanceId & SceneData.InstanceDataTileSizeMask;
	return SceneData.InstanceDataTileStride * TileId + (ArrayIndex << SceneData.InstanceDataTileSizeLog2) + IdInTile;
}
先按 InstanceId 分 tile(默认每个 tile 4096 个实例,r.GPUScene.InstanceDataTileSizeLog2 = 12,GPUScene.cpp:142),tile 内先放所有实例的第 0 个 float4,再放所有实例的第 1 个 float4,依此类推。
这样排的原因:剔除 shader 里相邻线程处理相邻的 InstanceId(§6、§8),它们读同一个 ArrayIndex 时地址连续,读取天然合并(coalesced)。tile 同时也是 buffer 生长的单位:平铺布局下 buffer 按 tile 数折算并向上取整到 16MB 的整数倍来增减,减少页表更新和 resize 的次数(GPUScene.cpp:985-991);支持 reserved resource 的平台会先预留 2048MB 的虚拟地址空间(GPUScene.cpp:952)。r.GPUScene.InstanceDataTileSizeLog2 设为负数则关闭平铺,同时关闭 reserved resource。
GetInstanceSceneDataInternal(SceneData.ush:1111)把这些原始数据解码成 FInstanceSceneData:解压变换、推导 NonUniformScale 与 WorldToLocal(ComputeInstanceDerivedData)、取出局部包围盒和上一帧变换。有两点和剔除直接相关:
- 局部包围盒:实例带
HAS_LOCAL_BOUNDSflag 时用实例自己的包围盒(来自 payload);否则所有实例共用图元的InstanceLocalBoundsCenter / Extent; - 上一帧变换:实例带
HAS_DYNAMIC_DATA时取 payload 里存的上一帧变换;否则用图元的WorldToPreviousWorld把当前变换”推回”上一帧——实例本身不动、只有图元整体在动时,这样就够了。HZB 剔除要用它(§9.5)。
4.3 Payload 的组织方式
Instance 表放不下的可选数据放在 Payload 表(GPUSceneInstancePayloadData)。组织规则是:每个图元一段连续区域,图元内每个实例占固定的 InstancePayloadDataStride 个 float4。同一图元的所有实例共享同一套 flag,每个实例的 payload 长度相同,寻址是 O(1):
PayloadGlobalOffset = InstanceRelativeId * PrimitiveData.InstancePayloadDataStride
                    + PrimitiveData.InstancePayloadDataOffset
每个实例的 payload 内部是若干变长小节,是否存在由实例 flag 决定,顺序固定(GetInstancePayloadDataOffsets,SceneData.ush:999):
| 顺序 | 由哪个 flag 决定 | 占用 | 内容 |
|---|---|---|---|
| 1 | HAS_HIERARCHY_OFFSET / HAS_SKINNING_DATA / HAS_LOCAL_BOUNDS | 1 个 float4,带 LOCAL_BOUNDS 时 2 个 | float0.x = Nanite hierarchy 偏移;float0.y = 蒙皮数据;局部包围盒占 float0.zw 与 float1.xyzw |
| 2 | HAS_DYNAMIC_DATA | 2 个(压缩变换)或 3 个 float4 | 上一帧 LocalToWorld |
| 3 | HAS_EDITOR_DATA | 1 | 是否被选中 + HitProxy ID |
| 4 | HAS_LIGHTSHADOW_UV_BIAS | 1 | 光照图 / 阴影图 UV 偏移 |
| 5 | HAS_PAYLOAD_EXTENSION | InstancePayloadExtensionSize | 扩展数据 |
| 6 | HAS_CUSTOM_DATA | CustomDataCount 个 float | PerInstanceCustomData |
RandomID 不在 payload 里,直接内嵌在 Instance 表的 [0].w,读取最便宜。
4.4 实例数据如何进入 GPUScene
GPUScene 是增量更新的:只有变化的图元(dirty)才会重新上传。FGPUScene::UploadGeneral(GPUScene.cpp:1161)把待上传图元交给若干并行任务,其中的 “GPUScene Upload Instances Task”(GPUScene.cpp:1286)负责实例数据。它有一个和 §6 遥相呼应的设计——CPU 侧的上传也做负载均衡:
FInstanceBatcher(GPUScene.cpp:1060)把待上传图元的实例切成若干 batch,每个 batch 最多 64 个 item,代价按”一个图元 + 一个实例 = 各 1”估算(MaxCost = MaxItems * 2),让每个并行任务的工作量接近;- 每个任务里逐实例调
FInstanceSceneShaderData::BuildInternal打包,再用CalcInstanceDataIndex(InstanceId, RefIndex)(GPUScene.cpp:1362)算出每个 float4 在 tile-SoA 布局里的目的地,写入 scatter 上传缓冲;最后由FRDGAsyncScatterUploadBuffer(InstanceSceneUploadBuffer)在 GPU 上散射到InstanceSceneDataBuffer。
动态图元(每帧由 FMeshElementCollector 临时生成、不在场景里的图元)走另一条路:它们被收集到每个 view 的 DynamicPrimitiveCollector,帧内 UploadDynamicPrimitiveShaderDataForView 时才通过 CommitPrimitiveCollector(GPUScene.cpp:2066)向 InstanceSceneDataAllocator 申请槽位。它们的 InstanceId 因此在 mesh pass setup 时还不知道——这就是后面 DynamicInstanceDataOffset 标志和 BeginAsyncSetup 机制存在的原因(§5.5、§7.2)。
五、CPU 侧(一):从 MeshDrawCommand 到剔除任务
GPU 手里有了数据。接下来的问题是:CPU 要给 GPU 准备什么,才能让它知道”该对谁做剔除、结果该写到哪里”。答案是每个 mesh pass 一份 FInstanceCullingContext。
5.1 每个 pass 一份”剔除说明书”
FSceneRenderer::SetupMeshPass(SceneRendering.cpp:5010)为每个主视图 pass 创建一个 context(SceneRendering.cpp:5090),构造参数体现了它的定位:
| 参数 | 含义 |
|---|---|
ViewIds | 这个 pass 要对哪些”剔除视图”做剔除(下标指向 §9.2 里的 FPackedView 数组)。普通 pass 一个;立体渲染再加第二只眼;点光源单 pass 阴影有 6 个(立方体 6 个面) |
PrevHZB | 上一帧的 Furthest HZB,用于遮挡剔除;CustomDepth pass 不使用 |
InstanceCullingMode | Normal 或 Stereo(一个线程同时测两只眼) |
Flags | 编辑器选择 pass 带 DrawOnlySelected;阴影带 NoInstanceOrderPreservation(ShadowSetup.cpp:2695) |
SingleInstanceProcessingMode | 单实例图元走哪条处理路径,默认 UnCulled(§5.3);带 VSM 的阴影 pass 传 Generic(ShadowSetup.cpp:2690) |
CullingQuery | 5.8 新增的 CPU 层级预剔除查询(§5.4) |
context 内部的核心数据分成”按 draw 索引”和”按工作项索引”两类:
| 数据 | 索引方式 | 内容 |
|---|---|---|
IndirectArgs | 每个 draw 一条 | 5 个 uint32:IndexCount, InstanceCount, StartIndex, BaseVertex, StartInstance。CPU 只填 InstanceCount 之外的 4 项,InstanceCount 留给 GPU 累加 |
DrawCommandDescs | 每个 draw 一条 | 该 draw 的剔除配置:材质是否用 WPO、LOD 序号、最小 / 最大屏幕尺寸、动态包围盒下标(PackDrawCommandDesc,InstanceCullingContext.cpp:77) |
InstanceIdOffsets | 每个 draw 一条 | 该 draw 的输出区间在 InstanceIdsBuffer 里的起点 |
LoadBalancers[Generic / UnCulled] | 工作项 | (InstanceDataOffset, NumInstances, Payload) 三元组,§6 详述 |
PayloadData、DrawCommandCompactionData | 仅保序 draw 需要 | §5.5、§10 |
MeshDrawCommandInfos | 与最终 MDC 列表一一对应 | 提交阶段用:是否间接绘制、indirect args 偏移等 |
最容易混淆的是 draw 的下标贯穿了三张表:IndirectArgs[k]、DrawCommandDescs[k]、InstanceIdOffsets[k] 描述的是同一个 draw,工作项通过 Payload 里记录的 k 找到它们。GPU 解码 payload 拿到的 IndirectArgIndex 就是这个 k。
5.2 SetupDrawCommands 主循环
SetupDrawCommands(InstanceCullingContext.cpp:1453)由 FMeshDrawCommandPassSetupTask 在任务线程里调用(MeshDrawCommands.cpp:1168)。此前该任务已经完成:生成动态 MDC → 应用 view 覆盖 → 更新排序键 → 按 SortKey、StateBucketId 排序(FCompareFMeshDrawCommands,MeshPassProcessor.h:1826)。进入 SetupDrawCommands 时 MDC 列表已经有序,状态相同的 MDC 一定相邻。
flowchart TD
    A["遍历排好序的 FVisibleMeshDrawCommand"] --> B{"与上一个:同 StateBucket<br/>且剔除参数相同<br/>且直接/间接类型未变?"}
    B -- 是 --> C["丢弃该 MDC 本身<br/>它的实例并入上一个 draw"]
    B -- 否 --> D["新建 draw<br/>AllocateIndirectArgs / DrawCommandDesc<br/>InstanceIdOffset = 已分配槽位总数"]
    C --> E{"图元类型"}
    D --> E
    E -- "RunArray(HISM)" --> F["每个 run 一个 item"]
    E -- "FetchInstanceCountFromScene(ISM)" --> G["整段实例一个 item<br/>或按 CPU 层级剔除结果拆成多个"]
    E -- "其它" --> H["(InstanceSceneDataOffset, NumInstances) 一个 item"]
    F --> I["选 LoadBalancer:<br/>单实例且未强制 → UnCulled,否则 Generic"]
    G --> I
    H --> I
第一步:能不能并入上一个 draw? 这是 dynamic instancing 的落地点。合并条件有三个:
StateBucketId相同(PSO、材质、顶点流等一致);CullingPayloadFlags与CullingPayload相同(LOD 序号和屏幕尺寸范围一致,屏幕尺寸测试是按 draw 做的,§9.3);- 没有发生”直接 draw → 间接 draw”的切换(间接 draw 是 GPU 剔除的前提,两者不能共用一个 draw)。
另外,间接 + 保序的 draw 不参与合并,以免破坏各自的实例次序。
❗ r.MeshDrawCommands.DynamicInstancing 管不到这里。SetupDrawCommands 的调用点直接传了 bCompactIdenticalCommands = true(MeshDrawCommands.cpp:1170),合并无条件发生;Lumen Scene 的 mesh card 路径传的是 false,明确不合并(LumenSceneRendering.cpp:2684)。那个 CVar 的值只流向不走 GPUScene 的提交路径(MeshDrawCommands.cpp:1767)。
合并的效果非常可观:几百个同网格同材质的单实例图元(比如一片石头)会被压缩成一个 draw,它们的实例区间各自成为 item,都指向同一个 draw 的 payload,最终由 GPU 把它们的可见实例累加到同一个 InstanceCount 上。
第二步:新建 draw 时做什么? 三件事:
AllocateIndirectArgs(InstanceCullingContext.cpp:253)按 MDC 的图元类型算出IndexCount(三角形列表 ×3、四边形列表 ×4、带状 +2、线列表 ×2、点列表 ×1),连同FirstIndex、BaseVertex填好,InstanceCount = 0;- 记录
DrawCommandDesc; - 记录
InstanceIdOffsets= 当前已分配的槽位总数(TotalInstances × NumViews)。
第 3 点是这套设计里最巧妙的地方:输出区间按”最坏情况(所有实例都可见)“用前缀和方式预留。draw 0 占 [0, n0),draw 1 占 [n0, n0+n1)……每个 draw 只会在它是”最新分配的 draw”时继续吸纳后续被合并进来的实例,所以每个 draw 的区间总是连续的,整个 InstanceIdsBuffer 的大小等于全部实例数 × 视图数,与最终有多少可见无关。GPU 端每个 draw 用自己的 InstanceIdOffset 作为写入基址,用原子加得到的序号作为区间内偏移,区间互不相交,无需任何跨 draw 同步。
5.3 三类图元的入口,以及 Generic 与 UnCulled 的分流
决定”往这个 draw 里追加什么实例”的是图元类型(InstanceCullingContext.cpp:1636-1690):
| 图元类型 | 判断依据 | 追加的工作项 |
|---|---|---|
| HISM / 植被 | MDC 带 RunArray | HISM 仍由 CPU 的 cluster tree 做粗剔除,得到若干可见的实例 run [start, end]。每个 run 追加一个 item,并强制走 Generic(AddInstanceRunsToDrawCommand,InstanceCullingContext.cpp:393),由 GPU 做精剔除 |
| ISM | FetchInstanceCountFromScene | 实例数不从 MDC 取,而是 setup 时从场景图元读取 GetNumInstanceSceneDataEntries()。MDC 缓存时 NumInstances 被刻意改写为 1(MeshPassProcessor.cpp:941),这样实例数变化时不必重建 cached MDC,还能让不同实例数的 ISM 落进同一个 state bucket(r.InstancedStaticMeshes.FetchInstanceCountFromScene,默认开) |
| 其它 | 无 run、也不取场景实例数 | 普通静态网格:(InstanceSceneDataOffset, MDC->NumInstances) 一个 item |
工作项加入时要选择进哪个 Load Balancer(AddInstancesToDrawCommand,InstanceCullingContext.cpp:309):
// We special-case the single-instance (i.e., regular primitives) as they don't need culling (again), except where explicitly specified.
// In actual fact this is not 100% true because dynamic path primitives may not have been culled.
EBatchProcessingMode Mode = (NumInstances == 1 && !bForceInstanceCulling) ? SingleInstanceProcessingMode : EBatchProcessingMode::Generic;
LoadBalancers[uint32(Mode)]->Add(uint32(InstanceDataOffset), NumInstances, Payload);
TotalInstances += NumInstances;- Generic:完整剔除路径,所有特性可用。
- UnCulled:不做视锥 / 遮挡剔除,只是把实例 ID 写进输出区间(仍会计算 WPO 关闭距离,§9.3)。它对应已经在 InitViews 里做过图元级剔除的单实例图元——场景里数量最庞大的一类。让它们绕开 GPU 剔除,既省算力,又因为 shader 里
LOAD_BALANCER_SINGLE_INSTANCE_MODE的特化而省掉线程映射的开销(§6.3)。
⚠️ “单实例已被剔除过”并不 100% 成立,引擎注释自己也承认:动态路径的图元可能没被剔除过,却同样走 UnCulled。
这个分流由三个条件共同调节:
- ISM / HISM 会置
bForceInstanceCulling(InstancedStaticMesh.cpp:1644、HierarchicalInstancedStaticMesh.cpp:1306,注释为force ISM through Generic path even for a single instance cases),所以即使只有 1 个实例也走 Generic; - 多视图 pass(
ViewIds > 1且不是双眼立体)会把SingleInstanceProcessingMode整体改成Generic(InstanceCullingContext.cpp:1468-1473):立方体阴影的 6 个面各有不同的视锥,单实例图元也必须逐面测试才能少画; r.InstanceCulling.ForceInstanceCulling=1让所有 draw 都置bForceInstanceCulling(InstanceCullingContext.cpp:1529),单实例 draw 也走 Generic,用于调试。
bUseIndirectDraw 的判定在 InstanceCullingContext.cpp:1531:
const bool bUseIndirectDraw = bFetchInstanceCountFromScene || bAlwaysUseIndirectDraws || bForceInstanceCulling || (VisibleMeshDrawCommand.NumRuns > 0 || MeshDrawCommand->NumInstances > 1);其中 bAlwaysUseIndirectDraws 就是 SingleInstanceProcessingMode != UnCulled(:1507),所以多视图 pass 里所有 draw 都走间接。任一条件为真就走间接 draw。普通的单实例 UnCulled draw 不走间接——它直接用 CPU 已知的合并数量做一次普通的 instanced draw,InstanceIdsBuffer 仍由 CS 填写,顶点着色器照样凭它取数。
5.4 5.8 新增:CPU 侧层级预剔除(Scene Culling)
对超大 ISM(比如几十万棵草),GPU 逐实例剔除的开销也不小。5.8 在 CPU 侧加了一层空间层级预剔除,目的是在生成 item 之前就把整块看不见的实例丢掉。这个功能 2026 年 1 月加入,起初 r.SceneCulling.HierarchicalCPUCulling 默认关闭;5 月起对”带预计算实例包围盒的图元”默认开启,当前默认值是 true。另有一个只读开关 r.SceneCulling.HierarchicalCPUCulling.ProjectEnabled(默认 true),可以为整个项目关掉这套机制。
离线阶段:编辑器里对 ISM 的实例数据做预计算(PrecomputeOptimizationData),核心是 FInstanceDataHelpers::BuildSpatialHashData(InstanceDataHelpers.cpp:51,仅 WITH_EDITOR)。它把实例按空间位置排序,并把落在同一个空间哈希 cell 里的连续实例压缩成一个 FCompressedSpatialHashItem { Location, NumInstances, ExplicitBounds },同时产生重排表(ReorderTable),让实例在 GPUScene 里按空间局部性排列。于是一个 item 天然就是 GPUScene 里的一段连续实例——恰好就是剔除工作项要的形状。
运行时:FSceneCulling 是一个场景扩展,维护层级空间哈希网格;满足”非 Nanite、带预计算空间哈希、GpuLodInstanceRadius > 0”的图元才会登记 CPU culling 信息(SceneCulling.cpp:2800)。每帧对每个主视图(FSceneCullingRenderer::PreVisibilityTasks,SceneCullingRenderer.cpp:36)和每个阴影视图(ShadowSetup.cpp:2600)创建一个 FSceneCullingRendererHierarchicalCullingQuery,在图元可见性阶段的 LOD 计算里调用 ComputeCulling(SceneVisibility.cpp:1504 → SceneCullingRenderer.cpp:370):
- 逐 cell 做视锥 + 最大绘制距离测试,把结果写进
HashGroupVisibilityMask; - 同时对可见 cell 估算实例的最小 / 最大屏幕占比(
HashGroupMinMaxFootprints),据此算出一个更紧的 LOD 范围,而不是按整图元包围盒算。
消费:回到 SetupDrawCommands 的 ISM 分支(InstanceCullingContext.cpp:1649-1671)。如果该图元有 culling 信息,就不再把整段实例作为一个 item,而是按 cell 逐个检查:IsVisible(cell) 且 IsLODVisible(cell, 当前 MDC 的 LOD 屏幕尺寸范围) 的 cell 才追加 item。
int32 NumInstancesDrawn = 0;
int32 FirstInstance = 0;
for (int32 ItemIndex = 0; ItemIndex < PrimitiveCullingData->Items.Num(); ++ItemIndex)
{
	const auto& Item = PrimitiveCullingData->Items[ItemIndex];
	bool bIsVisible = CullingQuery->IsVisible(*PrimitiveCullingData, ItemIndex);

	// TODO: track start/end and only add once if e.g., all are visible?
	if (bIsVisible && CullingQuery->IsLODVisible(*PrimitiveCullingData, ItemIndex, MinMaxLODScreenSize))
	{
		AddInstancesToDrawCommand(CurrentIndirectArgsOffset, VisibleMeshDrawCommand.PrimitiveIdInfo.InstanceSceneDataOffset + FirstInstance, NumInstancesDrawn, Item.NumInstances, InstanceFlags, MaxGenericBatchSize);
		NumInstancesDrawn += Item.NumInstances;
	}
	FirstInstance += Item.NumInstances;
}要点是它只减少送进 GPU 的工作量,不改变 GPU 剔除的语义:留下来的 cell 里的每个实例仍会经过完整的 IsInstanceVisible。这是”粗筛 + 精筛”的两级结构:CPU 用极低成本按 cell 粗筛,GPU 再逐实例精筛。这套 Scene Culling 数据结构同时也服务于 Nanite 的 GPU 层级剔除(FSceneCullingRenderer::CullInstances,SceneCullingRenderer.cpp:111),这里只涉及非 Nanite 的 CPU 查询这一支。
5.5 Payload 打包、动态图元与保序
每个工作项带一个 26 bit 的 Payload(Load Balancer item 里给它留了 26 位,§6.2),最低 2 位是 flag,其余位是内容(常量定义在 InstanceCullingDefinitions.h:5-8):
| 位 | 含义 |
|---|---|
| bit 0 | PRESERVE_INSTANCE_ORDER:此工作项属于需要保序的 draw,Payload >> 2 是 PayloadData 数组的下标(扩展 payload) |
| bit 1 | DYNAMIC_INSTANCE_DATA_OFFSET:这些实例属于动态图元,InstanceId 需要在 GPU 上加上 view 级的动态偏移 |
| bit 2 及以上 | 普通情况下是 IndirectArgsOffset(该 draw 在 context 内的序号);保序时是扩展 payload 的下标 |
- 动态图元:前面提到动态图元的 InstanceId 在 setup 时未知。context 用
BeginAsyncSetup挂一个回调(MeshDrawCommands.cpp:1492-1508),等 GPUScene 把动态图元上传完毕后由SetDynamicPrimitiveInstanceOffsets补上偏移,GPU 端读到DYNAMICflag 时把DynamicInstanceIdOffset加到InstanceId上(InstanceCullingSetup.ush:35-40)。这是一种”晚绑定”:CPU 先按相对编号生成工作项,绝对编号推迟到 GPU 才解析。 - 保序:需要保持实例绘制顺序的 draw(比如半透明 ISM,
InstancedStaticMesh.cpp:1656里bPreserveInstanceOrder = IsTranslucentBlendMode(Material),移动端不支持)会在DrawCommandCompactionData里额外登记压缩块信息,GPU 剔除完成后需要两个额外 pass 把结果按原序压紧,详见 §10。保持的只是实例编号次序,并不是按深度排序,代码里留着改用实例深度排序的 TODO。
六、CPU 侧(二):Load Balancer
6.1 要解决的问题
每个 pass 的说明书里现在有一批 (InstanceDataOffset, NumInstances, Payload) 三元组,规模从 1 到十几万不等。GPU 要做的是”一个线程处理一个实例”。几个朴素方案都有明显缺陷:
- 一个 draw 一个线程组:只有 1 个实例的 draw 也占用整个线程组(63/64 的线程空转),而 10 万实例的 draw 却只能被一个线程组串行处理;
- 每个线程二分查找自己属于哪个 draw:需要一张很大的前缀和表,且每个线程要 log N 次访存;
- CPU 展开成逐实例的表:把 GPU 剔除的收益又以”CPU 展开”的成本还了回去。
Load Balancer 的想法是:把所有区间首尾相接看成一条长序列,每 64 个实例切一刀,每一刀就是一个线程组的工作(batch);区间若跨过刀口就被拆成两个 item。 CPU 只需一个贪心的 Add,GPU 只需在线程组内做一次很小的映射。
6.2 CPU 侧:Add 与打包格式
TInstanceCullingLoadBalancer::Add(InstanceCullingLoadBalancer.h:134)的逻辑一句话:往当前 batch 尽量塞,塞满 64 就开新 batch。
void Add(uint32 InstanceDataOffset, uint32 NumInstanceDataEntries, uint32 Payload)
{
	uint32 InstancesAdded = 0;
	while (InstancesAdded < NumInstanceDataEntries)
	{
		uint32 MaxInstancesThisBatch = ThreadGroupSize - CurrentBatchPrefixSum;

		if (MaxInstancesThisBatch > 0)
		{
			const uint32 NumInstancesThisItem = FMath::Min(MaxInstancesThisBatch, NumInstanceDataEntries - InstancesAdded);

			Data->Items.Add(PackItem(InstanceDataOffset + InstancesAdded, NumInstancesThisItem, Payload, CurrentBatchPrefixSum));
			// ...
			CurrentBatchNumItems += 1U;
			InstancesAdded += NumInstancesThisItem;
			CurrentBatchPrefixSum += NumInstancesThisItem;
		}

		// Flush batch if it is not possible to add any more items (for one of the reasons)
		if (MaxInstancesThisBatch <= 0U || CurrentBatchPrefixSum >= ThreadGroupSize)
		{
			Data->Batches.Add(PackBatch(CurrentBatchFirstItem, CurrentBatchNumItems));
			CurrentBatchFirstItem = uint32(Data->Items.Num());
			CurrentBatchPrefixSum = 0u;
			CurrentBatchNumItems = 0U;
			// ...
		}
	}
	TotalInstances += InstancesAdded;
}
四个区间 A(150)、B(10)、C(30)、D(5)依次加入的结果如下:A 被拆成 64 + 64 + 22,B、C 紧跟在 A 的尾巴后面,D 被 batch 2 的最后 2 个位置和 batch 3 各分走一部分。
图 1:Load Balancer 把实例区间打包进 64 线程的 batch。每个色块是一个 item,括号里的数字是该 item 的 BatchPrefixOffset,即它在 batch 内的起始线程号。
两个打包结构的位域(InstanceCullingLoadBalancer.h:33-65,常量 ThreadGroupSize=64, PrefixBits=6, NumInstancesItemBits=7):
| 结构 | 第 1 个 uint32 | 第 2 个 uint32 |
|---|---|---|
FPackedItem | InstanceDataOffset << 7 按位或 NumInstances(高 25 位 + 低 7 位) | Payload << 6 按位或 BatchPrefixOffset(高 26 位 + 低 6 位) |
FPackedBatch | FirstItem << 7 按位或 NumItems(高 25 位 + 低 7 位) | — |
NumInstances 需要 7 位而不是 6 位,是因为一个 item 恰好占满整个 batch 时要表示”64”,头文件注释里也特别提到了这一点。一个 item 只有 8 字节:有十几万实例的大 ISM 只会产生约”实例数 / 64”个 item,CPU 上传的数据量很小;场景里大量的单实例图元则是每个图元一个 item。
6.3 GPU 侧:一个线程如何找到自己的实例
一个线程组恰好处理一个 batch。每个线程要回答一个问题:“我是这个 batch 里第几个线程,它对应哪个 item 的第几个实例?“InstanceCullingLoadBalancer_Setup(InstanceCullingLoadBalancer.ush:164)分三种情形处理,越简单的越先短路:
| 情形 | 条件 | 做法 |
|---|---|---|
| 一一对应 | NumItems == 64(每个 item 恰好 1 个实例) | 线程 i 直接取第 i 个 item,无需任何同步 |
| 线性搜索 | NumItems < 4 | 把 item 读进共享内存,每个线程从后往前找”起始线程号不超过自己”的第一个 item |
| 前缀最大值 | 其它 | 见下 |
前缀最大值(PrefixMax,InstanceCullingLoadBalancer.ush:115)的思路:前 NumItems 个线程各自把一个 item 读进共享内存 Items[],并在 ItemIndex[item.BatchPrefixOffset] 处写下自己的序号——相当于在”每个 item 的起始线程号”位置立一根旗,旗上写着 item 序号,其它位置为 0。接着做一次 6 步(log2(64))的 Hillis-Steele 式扫描取前缀最大值,每个线程就得到了”不超过我线程号的最近一根旗”,也就是自己所属的 item 序号:
线程号:      0  1  2  3  4  5  6  7  8  9 10 ...
立旗后:      0  .  .  .  .  .  .  .  1  .  .  ...   (item0 起始于 0,item1 起始于 8)
前缀最大值:   0  0  0  0  0  0  0  0  1  1  1  ...
然后 LocalItemIndex = GroupThreadIndex - Item.BatchPrefixOffset;若它落在 [0, Item.NumInstances) 内则线程有效,否则是 batch 尾部的空闲线程,直接返回。最后
InstanceId = Item.InstanceDataOffset + LocalItemIndex (item 属于动态图元时再加 DynamicInstanceIdOffset)
这一步在 InstanceCullingSetup.ush:33。相邻线程得到相邻的 InstanceId,与 §4.2 的 tile-SoA 布局配合,读取实例数据天然合并。
UnCulled 模式的特化:单实例 item 满足”每个 item 恰有 1 个实例”,编译时定义 LOAD_BALANCER_SINGLE_INSTANCE_MODE,线程 i 直接取第 i 个 item(InstanceCullingLoadBalancer.ush:184-190),连”一一对应”里的 64 判断都省了。
引擎里还留着一版基于 wave ballot 的映射(USE_WAVE_BIT_PREFIX_WORK_DISTRIBUTION),目前被固定置 0,代码里的 TODO 写明原因是尚未处理 wave 宽度不等于线程组大小的情况。
6.4 用抓帧数据验证
下面这张截图里,Name / Value 列表是一个 batch 里 3 个 item 的原始打包值:

图 2:一个 batch 里 3 个 item 的打包值(InstanceDataOffset_NumInstances,Payload_BatchPrefixOffset)。
按 §6.2 的位域逐项解码:
| item | InstanceDataOffset_NumInstances | → 起始实例 / 个数 | Payload_BatchPrefixOffset | → Payload / batch 内起始线程 | Payload >> 2(draw 序号) |
|---|---|---|---|---|---|
| 0 | 264 = 2<<7 + 8 | 实例 [2, 10),共 8 个 | 256 = 4<<6 + 0 | Payload 4,线程 0 起 | 1 |
| 1 | 4618 = 36<<7 + 10 | 实例 [36, 46),共 10 个 | 520 = 8<<6 + 8 | Payload 8,线程 8 起 | 2 |
| 2 | 5896 = 46<<7 + 8 | 实例 [46, 54),共 8 个 | 786 = 12<<6 + 18 | Payload 12,线程 18 起 | 3 |
解码结果自洽:Payload 依次为 4、8、12(对应 draw 序号 1、2、3),BatchPrefixOffset 依次为 0、8、18,恰好是各 item 实例数(8、10、8)的前缀和。三个 item 依次占用线程 [0,8)、[8,18)、[18,26),共 26 个有效线程,剩下的 38 个线程是 batch 尾部的空闲线程。NumItems = 3 < 4,这个 batch 走的是”线性搜索”分支。
图 3 是另一份 ItemBuffer 的原始 uint,与图 2 不是同一批 item(注意 260 与 264 不同):
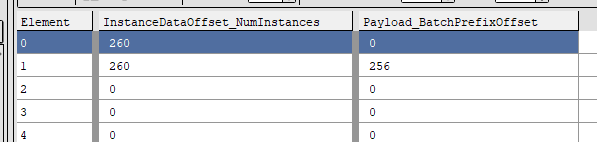
图 3:ItemBuffer 原始值。前两项的 InstanceDataOffset_NumInstances 都是 260 = 2<<7 + 4,即从实例 2 起的 4 个实例;Payload_BatchPrefixOffset 分别为 0 和 256,对应 Payload 0 与 Payload 4(draw 序号 0 与 1),各自从所在 batch 的线程 0 开始。
七、跨 pass 合批:Merged Context 与 Deferred Context
前两章把每个 pass 的说明书准备好了。如果每个 pass 各自 dispatch 一次,一帧就会有几十次很小的 dispatch(一个只有几百个实例的阴影 pass 只会用到 4 个线程组),再加上各自的 buffer 创建和 barrier。这一章讲怎样把它们合并成寥寥几次 dispatch。
7.1 为什么能合
合并可行,是因为前面的设计已经把”context 特有的信息”和”通用工作”分开了:
- 每个工作项自带
Payload,能定位到它所属的 draw; - 每个线程组(batch)可以通过
BatchInds反查到它所属的 context,进而读到 context 级参数:视图列表、flag、动态偏移、indirect args 偏移、payload 偏移……(FContextBatchInfoPacked,InstanceCullingMergedContext.h:24); - 输出缓冲区是所有 context 输出的拼接,每个 pass 通过自己的
FInstanceCullingDrawParams(InstanceCullingContext.h:33)里的InstanceDataByteOffset与IndirectArgsByteOffset访问属于自己的那一段。
7.2 难点在时序:RDG 的”延迟回调”
真正的难题是时序。合并必须等所有 pass 都登记完才能做(否则不知道总大小),但 RDG 的 pass 和资源又必须在构建期就声明好;更糟的是,mesh pass 的 setup 任务本身还在别的线程上异步执行,BuildRenderingCommands 被调用时,有的 context 甚至还没准备好。
代码的解法是把”声明”和”求值”拆开,充分利用 RDG 的延迟求值接口(CreateBuffer 的 NumElementsCallback、QueueBufferUpload 的数据 / 大小回调、AddPass 的 dispatch 尺寸回调):
- 声明阶段:帧首
BeginDeferredCulling→CreateDeferredContext(InstanceCullingContext.cpp:1037)一次性把合并后的 buffer 和 CullInstances pass 声明进 RDG,但所有大小、初始数据、dispatch 线程组数都以 lambda 传入,先不求值; - 登记阶段:各 pass 在自己的 RDG 构建代码里调用
BuildRenderingCommands(比如BasePassRendering.cpp:1473),它只做两件事——把 context 与该 pass 的FInstanceCullingDrawParams*塞进Batches(context 还在异步 setup 时放进AsyncBatches),并把 DrawParams 里的 buffer 引用指向全局合并 buffer。后者让 RDG 自动建立依赖:raster pass 读取 indirect args 和InstanceIdsBuffer,因此一定排在合并的剔除 pass 之后; - 求值阶段:RDG 开始 Execute、第一次需要某个缓冲的大小或数据时,对应的回调被求值。这些回调(见下面的宏)第一件事都是调用
DeferredContext->ProcessBatched(InstanceCullingContext.cpp:989),其中bProcessed保证只执行一次,内部调MergeBatches完成合并。此后所有回调返回的都是确定的.Num()/.GetData()。FInstanceCullingManager::BeginDeferredCulling的头文件注释说的正是这一点:batchare processed when RDG Execute or Drain is called。
读这段代码时最容易觉得”多余”的是 CreateDeferredContext 里那串宏(InstanceCullingContext.cpp:1054):
#define INST_CULL_CALLBACK(CustomCode) \
	[PassParameters, DeferredContext]() \
	{ \
		DeferredContext->ProcessBatched(PassParameters); \
		return CustomCode; \
}看起来啰嗦,只是”返回一个值”,但它保证了任何一个值在被取用之前,合并已经发生。宏只是给 RDG 的延迟求值接口套了一层统一模板:INST_CULL_CREATE_STRUCT_BUFF_ARGS(ArrayName) 一次生成(元素个数、初始数据指针、数据大小)三个回调,用于创建结构化缓冲;INST_CULL_CALLBACK_BIN_INDEX 是按 bin 取值的变体。
FInstanceCullingDrawParams 是 RDG 分配的 POD,头文件注释指出它会被延迟的剔除 pass 捕获,因此必须具有 RDG 生命周期(InstanceCullingContext.h:187)。原因是合并时要把每个 pass 的偏移回写进这个结构体(MergeBatches 处理每个 batch 时写入 InstanceDataByteOffset 与 IndirectArgsByteOffset),而 raster pass 的 lambda 在更晚的执行阶段才会读它。
7.3 MergeBatches:只追加、不改写
FInstanceCullingMergedContext::MergeBatches(InstanceCullingMergedContext.cpp:30)先对每个异步 context 调 WaitForSetupTask,再逐 context 把数据追加到合并数组里。设计要点是”packed 数据一律不改写,只记录每个 context 的偏移,让 GPU 解码时再叠加”:
| 数据 | 合并方式 | GPU 侧如何还原 |
|---|---|---|
IndirectArgs、DrawCommandDescs | 直接追加;追加前的长度记为 BatchInfo.IndirectArgsOffset | IndirectArgIndex = BatchInfo.IndirectArgOffset + (Payload >> 2) |
InstanceIdOffsets | 逐项加上该 context 在合并 InstanceIdsBuffer 里的起点后追加(需要改写的数据之一,另一个是压缩数据里的几个偏移) | InstanceIdOffsetBuffer[IndirectArgIndex] 已是全局写入基址 |
ViewIds | 追加;记 ViewIdsOffset;NumViewIds 与两个 flag(“允许遮挡剔除”= PrevHZB 有效、“只画选中”)打包进同一个字段 | LoadBatchInfo 解包 |
Load Balancer 的 Batches / Items | AppendData,不改写 packed 值(其中的 FirstItem 是 context 内的相对下标);追加前 items 数组的长度记为 BatchInfo.ItemDataOffset[Mode] | UnpackBatch(..., ItemDataOffset) 时叠加 |
PayloadData | 直接追加;追加前的长度记为 BatchInfo.PayloadDataOffset | 扩展 payload 下标叠加 PayloadOffset,其中的 IndirectArgIndex、CompactionDataIndex 再分别叠加各自的 context 偏移(InstanceCullingCommon.ush:158) |
DrawCommandCompactionData | 追加,并给 BlockOffset、IndirectArgsIndex、SrcInstanceIdOffset、DestInstanceIdOffset 逐项叠加该 context 的偏移 | 见 §10 |
| batch → context 映射 | 每追加一个 batch,往 BatchInds[bin] 里记一个 context 序号 | 线程组 id → BatchInfos[BatchInds[GroupId]](InstanceCullingCommon.ush:84-86) |
于是合并近乎纯 memcpy,可以在渲染线程上很快完成。
7.4 Bin:为什么剔除 dispatch 不只一次
一次 dispatch 只能绑定一张 HZB 纹理,而不同的主视图(分屏、多视图)有各自的上一帧 HZB。所以 Load Balancer 被分成若干 bin(FInstanceCullingManager::GetBinIndex,InstanceCullingManager.cpp:55):
- bin 0:所有 context 的
UnCulled工作项,不需要 HZB; - bin 1..N:
Generic工作项,按 context 的PrevHZB归类,N 为不同主视图 HZB 的个数;没有 HZB 的 context(比如阴影)放进 bin 1,并靠 batch 的”允许遮挡剔除”flag 跳过 HZB 测试。
CreateDeferredContext 里 NumBins = Max(2, ViewPrevHZBs.Num() + 1)(InstanceCullingContext.cpp:1045)。AddBatch 只在 PrevHZB 有效且 IsOcclusionCullingEnabled() 时才按 HZB 查 bin,否则一律进 bin 1(InstanceCullingMergedContext.cpp:166-177),所以默认配置下(r.InstanceCulling.OcclusionCull=0)所有 Generic 工作项都落在 bin 1。
每个 bin 一次 dispatch,RDG 事件名形如 CullInstances(Generic). Bin 1(InstanceCullingContext.cpp:1257)。
7.5 哪些 context 不走合批
BuildRenderingCommandsInternal(InstanceCullingContext.cpp:695)里,同时满足以下条件才会 defer(:717):非同步请求、IsDeferredCullingActive()、InstanceCullingMode == Normal。以下情况走”每个 context 单独 dispatch”的路径(shader 里 ENABLE_BATCH_MODE = 0):
- RDG 立即模式(
FRDGBuilder::IsImmediateMode())——无法延迟求值; r.InstanceCulling.AllowBatchedBuildRenderingCommands = 0;- 立体渲染(
Stereo模式)——它需要STEREO_CULLING_MODE的专用 permutation(一个线程同时测两只眼); - 显式要求同步的调用(
BuildRenderingCommands(..., FInstanceCullingResult&)重载,比如 Lumen Scene 的 mesh card 渲染路径,LumenSceneRendering.cpp:2688); - GPUScene 中没有实例,或没有注册任何剔除视图(
BeginDeferredCulling根本不创建 deferred context)。
读 shader 时常见的一个疑问是:ENABLE_BATCH_MODE 指的是”一次统一处理”,还是”每个 pass 前各处理一次”?答案是前者:ENABLE_BATCH_MODE = 1 表示这是合并后的多 context dispatch,BatchInfo 从 BatchInfos 里按线程组取;= 0 表示单 context dispatch,BatchInfo 由 kernel 参数直接构造,所以偏移类字段全是 0——在抓帧里看到 BatchInfo 的各项偏移都是 0,就是这个原因。它与 RDG 的立即模式直接相关:立即模式下无法延迟求值,只能走单 context 路径。
帧中途如果有 GPU 改写 GPUScene 实例数据的 pass(ExecuteDeferredGPUWritePass,DeferredShadingRenderer.cpp:3943),后续 pass 需要一个新的 deferred context,因此会再调用一次 BeginDeferredCulling(DeferredShadingRenderer.cpp:3945)。
八、GPU 侧:CullInstances compute shader
CPU 的说明书和合并后的 buffer 准备好了,现在进入 GPU。入口是 InstanceCullBuildInstanceIdBufferCS(BuildInstanceDrawCommands.usf:243),对应的 C++ 类是 FBuildInstanceIdBufferAndCommandsFromPrimitiveIdsCs(InstanceCullingContext.cpp:492)。
8.1 Permutation:一个 shader,七个开关
| 维度 | 含义 |
|---|---|
SINGLE_INSTANCE_MODE | 处理 UnCulled 的单实例工作项(对应 bin 0) |
CULL_INSTANCES | 是否做剔除。r.CullInstances 关闭、或处理的是 UnCulled 工作项时为 0;管线仍会运行,只是不测可见性 |
ALLOW_WPO_DISABLE | 是否计算 WPO 关闭距离。合批路径恒为开,单 context 路径只要有 FInstanceCullingManager 就为开。C++ 里的注释写明”实例剔除会强制带上 WPO 关闭距离检查”,所以不编译”剔除开而 WPO 关”的组合(InstanceCullingContext.cpp:526-531) |
OCCLUSION_CULL_INSTANCES | 是否绑定 HZB 做遮挡剔除:PrevHZB 有效且 r.InstanceCulling.OcclusionCull 打开 |
STEREO_CULLING_MODE | 双眼立体:一个线程同时测两只眼 |
ENABLE_BATCH_MODE | 合并模式(§7.5) |
ENABLE_INSTANCE_COMPACTION | 支持保序压缩(§10) |
8.2 一个线程的完整流程
图 4:一个线程的剔除流程。先解码所属 batch、实例与 draw 的信息,逐 view 判定可见性,再按 draw 是否保序选择写出方式。
几个要点:
- 一个线程组 = 一个 batch,一个线程 = 一个实例。
InstanceId由 §6.3 的映射得到;Payload解码出IndirectArgIndex(即 draw 序号 k),再据 k 取DrawCommandDesc与输出基址InstanceIdOffsetBuffer[k]。 - 多视图:context 有多个 view(立方体阴影 6 面等)时,线程对每个 view 各判一次,每个可见的 (实例, view) 对写一条记录,
ViewIdIndex一起打包进输出。因此InstanceCount计数的是”可见的 (实例, view) 对”的个数,输出区间大小也因此是实例数 × 视图数。 - 立体模式:两只眼各判一次,任意一只眼可见就把两只眼的记录都写出去(一次
InterlockedAdd(…, 2)占两格,BuildInstanceDrawCommands.usf:326)。两只眼的记录因此总是成对出现,与立体渲染”一个 instanced draw 同时画两只眼”的方式相匹配。
输出的核心逻辑在 BuildInstanceDrawCommands.usf:351-353:
uint OutputOffset;
InterlockedAdd(DrawIndirectArgsBufferOut[Payload.IndirectArgIndex * INDIRECT_ARGS_NUM_WORDS + 1], 1U, OutputOffset);
WriteInstance(InstanceDataOutputOffset + OutputOffset * INSTANCE_DATA_STRIDE_ELEMENTS, InstanceId, PrimitiveData, InstanceData, ViewIdIndex, CullingFlags, DrawCommandDesc.MeshLODIndex);
桌面平台上 WriteInstance(:90)展开后就是打包再写入,INSTANCE_DATA_STRIDE_ELEMENTS 为 1:
uint PackedId = PackInstanceCullingOutput(InstanceId, ViewIdIndex, CullingFlags);
InstanceIdsBufferOut[Offset] = PackedId;
+ 1 指的是 DrawIndexedIndirect 参数里的第 1 个字(0 起),也就是 InstanceCount。原子加返回的旧值同时充当”该 draw 输出区间内的写入序号”,计数和定位用一次原子操作完成。代码里留着两条 TODO(:348-350):同一线程组内所有 item 指向同一个 draw 时可以改用 wave 集体操作;只有一个 item 且不剔除时可以省掉原子操作。目前都没有做。
8.3 输出的格式:一个 uint32 里塞了三样东西
PackInstanceCullingOutput(SceneData.ush:1275):
| 位 | 内容 |
|---|---|
| bit 0–23 | InstanceId(24 bit) |
| bit 24–27 | CullingFlags(4 bit)。目前只有 bit 0 = INSTANCE_CULLING_FLAG_EVALUATE_WPO:顶点着色器是否需要对该实例计算 WPO |
| bit 28–31 | ViewIndex(4 bit):该记录属于本 pass 的第几个 view,是 pass 内的下标而不是全局 view id;因此每个 pass 最多 16 个 view |
输出不只是”可见 / 不可见”,还带着一个”质量档位”:距离超出 WPO 关闭距离的实例,可见但被清掉 EVALUATE_WPO 位,顶点着色器据此跳过 WPO(LocalVertexFactory.ush:896:bEvaluateWorldPositionOffset = (CullingFlags & INSTANCE_CULLING_FLAG_EVALUATE_WPO) != 0,材质”总是求值 WPO”时除外)。这是把剔除阶段已经算好的距离信息零成本地传递给绘制阶段。没有走实例剔除的路径,则由顶点着色器自己做这项距离检查(LocalVertexFactory.ush:1017)。
8.4 前后两个辅助步骤
- 清零:CPU 上传 indirect args 时
InstanceCount本就是 0,但代码仍会在剔除前额外跑一个ClearIndirectArgInstanceCountpass,把每个 draw 的这一项清零(shader 入口ClearIndirectArgInstanceCountCS在BuildInstanceDrawCommands.usf:372,C++ 类FClearIndirectArgInstanceCountCs在InstanceCullingContext.cpp:1363)。调用处的注释解释说,某些主机平台的 replay 有问题,所以冗余地清一次(:824、:1138)。原子累加因此从 0 起算。 - 没有实例的情形(非合批路径):如果
TotalInstances == 0,剔除 pass 被整个跳过,此时需要显式AddClearUAVPass把InstanceIdsBuffer清一下,好让 RDG 认为它已被写过、可以被后续 pass 绑定(InstanceCullingContext.cpp:957-959)。
8.5 用抓帧数据走一遍完整例子
把 §6.4 的三个 item 接着往下推。假设这是主视图的某个 pass,NumViewIds = 1。从数值看,这个 pass 至少有 4 个 draw(序号 0–3):draw 1–3 是 §6.4 里三个 item 的 Payload >> 2 指向的 draw;draw 0 是一个只有 1 个实例的 draw(从后面它的输出值来看,应当走的是 UnCulled 路径)。按 §5.2 的”最坏情况预留”,InstanceIdOffsets = [0, 1, 9, 19],正是下面这张截图的内容:
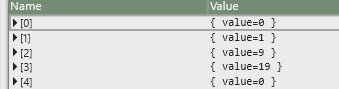
图 5:InstanceIdOffsetBuffer。每个 draw 在 InstanceIdsBuffer 里的起点:0、1、9、19。
也就是说 draw 0 占 1 格 [0],draw 1 占 8 格 [1, 9),draw 2 占 10 格 [9, 19),draw 3 占 8 格 [19, 27)。GPU 跑完之后的 InstanceIdsBuffer:
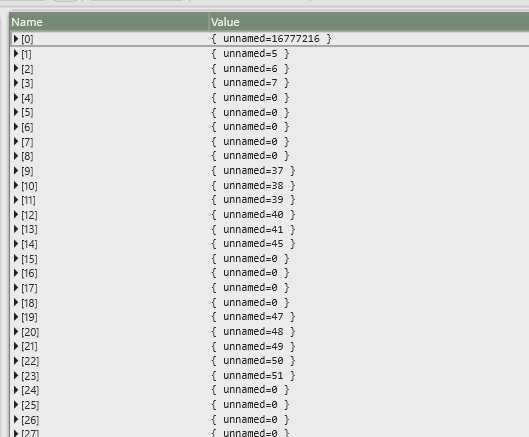
图 6:剔除后的 InstanceIdsBuffer(InstanceCulling.InstanceIdsBuffer)。
逐段解读:
[0] = 16777216 = 0x01000000:InstanceId = 0、CullingFlags = 1(EVALUATE_WPO置位)、ViewIndex = 0。这是 draw 0 写的。flag 保持默认值,与 UnCulled 路径的行为吻合:UnCulled 不做剔除,且图元没有 WPO 关闭距离时IsInstanceVisible直接返回,flag 不被改动;[1..3] = 5, 6, 7:draw 1 的 8 个实例(InstanceId2…9)里只有 5、6、7 存活。这些值没有1<<24,说明EVALUATE_WPO位被清掉了——按 §9.3 的逻辑,应当是这些图元的 WPO 求值标志没有置位(材质里没有 WPO,或组件关掉了 WPO 求值),Cull.bEnableWPO为 false;[9..14] = 37, 38, 39, 40, 41, 45:draw 2 的 10 个实例(36…45)里 6 个存活;[19..23] = 47…51:draw 3 的 8 个实例(46…53)里 5 个存活。
由此可以反推这三个 draw 的 indirect args 里 InstanceCount 应分别为 3、6、5,正好是各段”从头开始连续有效”的长度。
❗ 看到大片的 0,很容易以为”0 是预留位置,代表不可见”。实际上每个 draw 的输出区间按最坏情况预留,前 InstanceCount 个槽位是有效实例,后面的槽位根本没有被写入,内容是未定义的,绘制时也只会读取前 InstanceCount 个。截图里未写入的槽位恰好显示为 0,只是这次抓帧的观察,没有任何保证。InstanceId = 0 本身是个合法实例,所以打包值为 0 不能当作”无效”的标记([0] 的 0x01000000 就是一个合法条目)。各段内 ID 看起来递增,是同一线程组里原子加恰好按线程序发生的结果,并不是保证——需要保序时必须走 §10 的路径。
一张图把整条链路串起来(实例区间 → 线程 → 输出缓冲 → indirect args):
图 7:以图 2、图 5、图 6 的数据为例,从 GPUScene 实例区间到 InstanceIdsBuffer 与 indirect args 的完整数据流。
九、判定算法细则:IsInstanceVisible
9.1 判定顺序:由便宜到昂贵,逐级短路
IsInstanceVisible(BuildInstanceDrawCommands.usf:117)的整体结构是一条”过滤链”,每一级只在前面都通过时才执行:
图 8:IsInstanceVisible 的判定顺序。前置判定处理无效实例、编辑器选择过滤和零包围盒;其余实例依次经过 FBoxCull 的各个剔除阶段,任一阶段判定不可见即被剔除。
前置判定有三项:ValidInstance 为 false 直接不可见;编辑器里 bDrawOnlySelected 且实例带编辑器数据却未被选中,同样不可见;局部包围盒 extent 为 0(dot(Extent, Extent) <= 0)则直接判可见,这是给 FDynamicMeshBuilder::GetMesh 那类空包围盒动态图元的兜底,代码里标注了将来应改为计算合理包围盒(:135-141)。
此后任何一级把 bIsVisible 置 false,后面昂贵的测试(尤其是 8 个角点投影和 HZB 采样)都会被 BRANCH if (Cull.bIsVisible) 跳过。
9.2 剔除视图:为什么用 Nanite 的 view 结构
ViewIds[ViewIdIndex] 得到的 ViewDataIndex 指向 FRendererViewDataManager 维护的 FPackedView 数组(ViewData.cpp),shader 里用 GetNaniteView(ViewDataIndex) 读取。这个结构与 Nanite 完全共用:主视图在 FRendererViewDataManager 构造时登记(RegisterPrimaryView,ViewData.cpp:82),阴影 / 立方体面等非主视图在 setup 时通过 FInstanceCullingManager::RegisterView 登记,返回的整数就是 context 里的 ViewIds。
复用带来两个好处:一是剔除语义与 Nanite 完全一致——同一份距离、WPO、clip plane、屏幕尺寸逻辑,FBoxCull 结构就直接取自 NaniteCullingCommon.ush;二是主视图上一帧的矩阵和 HZB 矩形(HZBTestViewRect、PrevTranslatedWorldToClip……)已经放在里面,遮挡剔除可以直接取用。
一个容易忽略的细节是 SetCullingViewOverrides(NaniteShared.cpp:205):阴影视图的剔除用主视图的原点和屏幕倍率计算距离与屏幕尺寸(函数里的注释是 Culling uses main view for distance and screen size),这样阴影的绘制距离和 LOD 选择会和主视图保持一致,不会出现”主视图已经切到低 LOD 而阴影还在用高 LOD”的不匹配。
9.3 距离、WPO 与屏幕尺寸(GPU LOD 选择)
绘制距离(FBoxCull::Distance,NaniteCullingCommon.ush:427)有两层:视图级的 RangeBasedCullingDistance(考虑包围球半径),以及图元级的 min / max 绘制距离(PRIMITIVE_SCENE_DATA_FLAG_INSTANCE_DRAW_DISTANCE_CULL,只比较实例中心到”剔除视图原点”的距离)。
WPO 关闭距离(ProgrammableRasterDistanceInternal,NaniteCullingCommon.ush:480):
bEnableWPO = 图元的 WPO 求值标志置位 && 当前实例可见
若图元有 WPO 关闭距离 且 材质不是"总是求值 WPO":
    bEnableWPO = (实例到视图原点距离² < InstanceWPODisableDistanceSquared)
图元的 WPO 求值标志是 EvaluateWorldPositionOffset() && AnyMaterialHasWorldPositionOffset()(PrimitiveSceneProxy.cpp:809),即组件没有关掉 WPO 求值,且至少有一个材质带 WPO。bEnableWPO 为 false 时,输出里的 EVALUATE_WPO 位被清除。所以绝大多数不带 WPO 的普通网格,Generic 路径输出里的这一位其实都是 0,这也是 §8.5 里 5、6、7 没有 1<<24 的原因。
屏幕尺寸(FBoxCull::ScreenSize,NaniteCullingCommon.ush:558)是 GPU LOD 选择的落地点,牵涉 CPU 与 GPU 的分工:
- CPU 侧:对启用 GPU LOD 的实例化图元(
GpuLodInstanceRadius > 0),一组实例里各个实例离相机远近不一,无法用一个 LOD 概括。可见性阶段于是不再选一个 LOD,而是用这组实例的包围球算出”最近的实例”和”最远的实例”两个虚拟位置,分别求 LOD,得到一个 LOD 范围(ComputeLODForMeshes带InstanceSphereRadius的重载,SceneManagement.cpp:1168,返回FLODMask::SetLODRange)。范围内的每个 LOD 都会生成一个 MDC,每个 MDC 的剔除 payload 里带着该 LOD 的屏幕尺寸区间:FStaticMeshSceneProxy::SetMeshElementScreenSize(StaticMeshSceneProxy.cpp:1294)里MaxScreenSize = GetScreenSize(LODIndex),MinScreenSize = GetScreenSize(LODIndex + 1);屏幕尺寸在 payload 里是 3.10 定点数(FMeshDrawCommandCullingPayload,MeshPassProcessor.h:1672)。§5.4 的 CPU 层级预剔除会用”可见 cell 的并集”取代整个包围球,把这个范围收得更紧。 - 范围两端各只测一个方向:
SceneVisibility.cpp:1719-1723的注释写得很清楚——At both ends of a LOD range we only want to cull by screen size in one direction. This ensures that all possible screen sizes map to one LOD in the range.也就是最精细的 LOD 不设屏幕尺寸上界,最粗糙的 LOD 不设屏幕尺寸下界。 - GPU 侧:每个实例计算自己的屏幕尺寸,只在其屏幕尺寸落入区间的那个 LOD 所属的 draw 中”存活”(
NaniteCullingCommon.ush:585-588):
float ScreenSizeSq = NaniteView.CullingViewScreenMultipleSq * RadiusSq / max(InstanceDrawDistSq, 1.0f);
float MinScreenSizeSq = MinScreenSize * MinScreenSize;
float MaxScreenSizeSq = MaxScreenSize * MaxScreenSize;
bIsVisible = ScreenSizeSq >= MinScreenSizeSq && (MaxScreenSize == 0 || ScreenSizeSq < MaxScreenSizeSq);
这段代码的注释要求它与 C++ 的 ComputeLODForMeshes()、ComputeBoundsScreenRadiusSquared() 保持一致,剔除结果才会与提交的 LOD 范围匹配。
于是 LOD 选择从”每图元一个”细化到了”每实例一个”,而 CPU 不需要为每个实例决定 LOD。屏幕尺寸区间的判定只在 MinScreenSize != MaxScreenSize 时执行:没有 LOD 范围的普通 draw(两者都是 0)会整条跳过。此外还有视图级的 NANITE_VIEW_MIN_SCREEN_RADIUS_CULL,把过小的实例直接丢掉;阴影用它剔除太小的投影者(ShadowSetup.cpp:2634,只对未缓存的非 VSM 阴影,或 VSM 的未缓存条目启用)。
⚠️ LOD 范围只按实例包围球半径估算,没有计入实例缩放的上下限,ComputeLODForMeshes 里留着对应的 TODO(SceneManagement.cpp:1177)。
9.4 视锥剔除:BoxCullFrustum
视锥测试的对象是”局部包围盒 × 实例变换”得到的有向包围盒(OBB),而不是先求世界 AABB 再求 AABB,因此更紧。透视情形的实现在 BoxCullFrustumPerspective(NaniteHZBCull.ush:444),有三个值得注意的技巧:
- 利用线性性省矩阵乘法:齐次裁剪空间里,位置是局部坐标的线性函数。所以只需对第一个角点做一次完整矩阵乘,再把局部 X / Y / Z 三条棱在裁剪空间里的增量
DX、DY、DZ(每个是矩阵一行乘2*Extent)预先算出来,其余 7 个角点都只需要加法。代码还特意把 8 个角点分成 4 段、每段 2 个角点,用PLATFORM_SPECIFIC_ISOLATE隔开,以控制寄存器压力; - 不归一化的平面测试:对每个角点算
x-w、y-w、-x-w、-y-w(正比于到四个侧面的有符号距离,内部为负),对 8 个角点取每个平面的最小值;只要某个平面上的最小值大于 0,就说明 8 个角点全部在该平面外侧,可以剔除(bFrustumCull = any(PlanesMin > 0.0f))。整个过程不需要归一化平面; - 近 / 远平面与 w 符号:用
MinW/MaxW加上投影矩阵[2][2]、[3][2]项推出 z 的范围,得到bCrossesNearPlane、bCrossesFarPlane和可见性;如果盒子横跨相机平面(MinW <= 0 < MaxW),无法做透视除法,就把屏幕矩形直接设为全屏。
第 1 点的角点递推(摘自 BoxCullFrustumPerspective,排版有压缩):
PC000 = mul(mul(float4(Center - Extent, 1.0), LocalToWorld), WorldToClip);   // 唯一一次完整矩阵乘
PC100 = PC000 + DZ;
PC001 = PC000 + DX;   PC101 = PC100 + DX;
PC011 = PC001 + DY;   PC111 = PC101 + DY;
PC010 = PC011 - DX;   PC110 = PC111 - DX;
结果是一个 FFrustumCullData:可见性、NDC 空间的矩形(RectMin / RectMax)和深度范围。矩形与深度正好是 HZB 测试需要的输入。正交投影的实现更简单:中心 ± Σ |Extent_i × 变换后的轴_i|(BoxCullFrustumOrtho,NaniteHZBCull.ush:414)。BoxCullFrustum(:543)按 bIsOrtho || !bNearClip 在两者之间分派。
9.5 HZB 遮挡剔除:用上一帧回答”这个实例上一帧是不是被挡住了”
整体思路:遮挡测试用的是上一帧的 Furthest HZB,所以要回答的其实是:“这个实例在它上一帧的位置,是否被上一帧的所有可见物体完全挡住?“具体步骤(BuildInstanceDrawCommands.usf:203-216):
- 用上一帧的矩阵重新投影:
BoxCullFrustum(…, DynamicData.PrevLocalToTranslatedWorld, NaniteView.PrevTranslatedWorldToClip, NaniteView.PrevViewToClip, …)。也就是先把包围盒放回上一帧的空间,因为 HZB 是上一帧的。PrevLocalToTranslatedWorld用的是实例的上一帧变换(§4.2),并通过PrevPreViewTranslationHZB换算到上一帧 HZB 所用视图的平移世界空间(NaniteSceneCommon.ush:28)。 - 只在能判断时才判断:若上一帧的包围盒整个落在相机之后 / 远平面之外(
!PrevCull.bIsVisible),或横跨近平面(PrevCull.bCrossesNearPlane),HZB 无法给出可靠结论,保守地当作可见。这里调用BoxCullFrustum时传了bSkipFrustumCull = true,侧面视锥测试被跳过:上一帧在屏幕外的实例,仍会用”夹到屏幕范围内的矩形”去测 HZB。这是一个近似的猜测,边缘处可能误剔。Nanite 里的同类代码靠后遍纠错(NaniteCullingCommon.ush:627-628),实例剔除没有后遍。 - 求屏幕矩形与 HZB mip(
GetScreenRect,NaniteHZBCull.ush:71):把 NDC 矩形换算成像素矩形——只把”像素中心被矩形覆盖”的像素算进去(函数里的注释说明,这比保守的 floor / ceil 通常少画约 5% 的 cluster);HZB 第 0 级是半分辨率,所以像素坐标右移一位;再由MipLevelForRect(:40)选最小的 mip,使矩形在该级覆盖不超过 4×4 个 texel(用firstbithigh而不是log2,因为前者在 GCN 上是满速指令)。 - 采样并比较(
GetMinDepthFromHZB/IsVisibleHZB,NaniteHZBCull.ush:135 / 195):用 4 次GatherLODRed(每次取 2×2 texel)覆盖 4×4 区域,取其中的最小深度。由于是反向 Z,HZB 存的是每个 texel 区域里最远的深度,“最小深度”就是整块区域里最远的遮挡深度;实例包围盒最近的深度是Rect.Depth(RectMax.z)。若Rect.Depth >= MinDepth,说明盒子最近的点不比区域里最远的遮挡深度更远,盒子有可能露出来,判可见;否则盒子最近的点也比区域内所有遮挡物都远,整个盒子被挡住,剔除。 - 精度补偿:HZB 用半精度存储,所以先做
RoundUpF16(PrevRect.Depth)(把深度向上取一个 half ulp,BuildInstanceDrawCommands.usf:112),避免实例被自己”挡住”。
代价与边界:这是单遍遮挡测试,用的是上一帧信息,所以一个刚刚因为遮挡物移开、或相机移动而”露出来”的实例,会因为上一帧 HZB 认为它被挡住而被多剔除一帧。这和 Nanite 的两遍遮挡剔除(主遍用上一帧 HZB,后遍用本帧 HZB 补救)不同——实例剔除没有后遍。这很可能就是 r.InstanceCulling.OcclusionCull 默认关闭、并标记为 Preview 的原因,也是 §3.3 里”能批量在帧首做”的代价。
启用条件:r.CullInstances = 1(默认)、r.InstanceCulling.OcclusionCull = 1(默认 0)、并且 context 的 PrevHZB 有效——这要求上一帧生成并提取了 Furthest HZB。是否生成 HZB 由 bFurthestHZB 决定(DeferredShadingRenderer.cpp:1428:r.HZBOcclusion、Nanite、SSAO、SSR、SSGI、Lumen 任一开启),是否提取给下一帧则是 ShouldRenderNanite() || FInstanceCullingContext::IsOcclusionCullingEnabled()(DeferredShadingRenderer.cpp:608)。
❗ r.HZBOcclusion 的 CVar 描述写着 1 是默认值,代码里的初值却是 0(SceneVisibility.cpp:126),Engine/Config/BaseDeviceProfiles.ini 的 [IOS DeviceProfile] 还显式把它设为 0。没有 Nanite / Lumen 等其它 HZB 使用者的配置下,需要把 r.HZBOcclusion 设为 1(或 2,强制启用)来保证 HZB 被构建。
9.6 实验特性:逐实例的软件遮挡查询
HZB 测试有两个不足:它只能给出保守的”可能可见”,并且只知道上一帧的 HZB。5.8 里还有一个实验特性(r.InstanceCulling.OcclusionQueries,默认 0,标为 ECVF_Preview):FInstanceCullingOcclusionQueryRenderer(InstanceCullingOcclusionQuery.cpp)用本帧的深度做更精确的逐实例可见性判定,并把结果留给下一帧的剔除使用。
它分两步(DeferredShadingRenderer.cpp:632 处调用 Render,发生在 HZB 构建之后):
-
筛选 CS(
MainCS,InstanceCullingOcclusionQuery.usf:154):以 BasePass context 的 Generic Load Balancer 为工作列表(即”本帧 base pass 要画的实例”,由r.InstanceCulling.UseLoadBalancer控制),对每个实例分类(GetInstanceDataAndVisibility,:47):Hidden:无效实例,或 HZB 测试已经确认被挡住;Visible:横跨近平面、本帧在视锥外、或屏幕矩形碰到屏幕边缘,都保守地当可见,避免下一帧出现突然冒出来的 pop-in;Incompatible:图元不允许用查询(PRIMITIVE_SCENE_DATA_FLAG_INSTANCE_CULLING_OCCLUSION_QUERIES未置位),按可见处理;PossiblyVisible:HZB 测试通过,需要更精确的判断。
只有
PossiblyVisible的实例被压缩进一个列表:组内原子计数,再由每组的一个线程对全局InstanceCount做一次原子加。 -
画包围盒:用 indirect draw 把这些实例的包围盒(36 个索引的立方体,extent 会额外加上
OcclusionSlop)画一遍,只做深度测试、不写深度(TStaticDepthStencilState<false, CF_DepthNearOrEqual>,InstanceCullingOcclusionQuery.cpp:266),并启用 early-z(EARLYDEPTHSTENCIL)。像素着色器只要被执行,就说明有像素通过了深度测试,于是它把该实例对应 view 的那一位写进InstanceOcclusionQueryBuffer:每实例一个uint8(硬件不支持 typed UAV 时退化为uint32),每个 view 占一位,最多 8 个 view,超出后静默退回不做该剔除(InstanceCullingOcclusionQuery.h:77)。
下一帧的 CullInstances 里,若该 view 的 InstanceOcclusionQueryMask 非 0,且 InstanceOcclusionQueryBuffer[InstanceId] & Mask == 0,实例就被剔除(BuildInstanceDrawCommands.usf:218-225)。GPUScene 里新分配的实例区间通过 MarkInstancesVisible(InstanceCullingOcclusionQuery.cpp:754)整体置为全 1,保证新实例第一帧不会被误剔除。
CVar 描述把它定位成比单纯 HZB “less conservative” 的可见性测试——更精确、更”激进”,剔除得更多,而不是更保守。shader 里的注释也坦承 Two-pass occlusion culling algorithm is the only robust solution(InstanceCullingOcclusionQuery.usf:94)。
❗ 这段比较写在 OCCLUSION_CULL_INSTANCES permutation 里,和 HZB 测试共用同一个开关:只开 r.InstanceCulling.OcclusionQueries、而 r.InstanceCulling.OcclusionCull 为 0,或者 PrevHZB 无效时,CullInstances 不会读这块 buffer。
十、保序:Instance Compaction 两阶段
10.1 为什么需要
§8.2 里”原子加得到写入序号”的方式简单高效,但可见实例在区间内的顺序是不确定的。对不透明物体这无所谓,对半透明的 ISM 却很关键:实例的绘制顺序决定混合结果。因此 FVisibleMeshDrawCommand 有 PreserveInstanceOrder flag(半透明 ISM 会设置,InstancedStaticMesh.cpp:1656),要求最终的实例序保持与实例编号一致。阴影 pass 则明确声明 NoInstanceOrderPreservation(ShadowSetup.cpp:2695)。
10.2 三步走
保序的 draw 在 CPU 侧会额外登记 FCompactionData(InstanceCullingContext.h:300):实例数与视图数、块偏移、indirect args 序号、临时缓冲里的起点 SrcInstanceIdOffset、最终缓冲里的起点 DestInstanceIdOffset。实例被划分成若干块(CompactionBlockNumInstances = 64,InstanceCullingContext.h:93)。
原序(每实例 × 每 view 一个槽):  A  x  C  x  x  F  G  x  ...        x = 0xFFFFFFFF(不可见)

阶段 0(CullInstances):  仍是一线程一实例,但写入"原序位置",不用原子加
                          临时缓冲[Src + 实例序 × 视图数 + 视图下标] = 可见 ? 打包 ID : 0xFFFFFFFF
                          同时 InterlockedAdd(CompactionBlockCounts[块], 该实例可见的 view 数)

阶段 1(CalculateCompactBlockInstanceOffsetsCS):每个 draw 一个线程组
                          对该 draw 的各块可见数做前缀和 → 每块的目的偏移 BlockDestInstanceOffsets
                          总和就是最终 InstanceCount,写回 indirect args

阶段 2(CompactVisibleInstances):每块一个线程组
                          读该块在临时缓冲里的一段,组内前缀和统计有效项
                          把有效项按序写到  Dest + BlockDest + 组内前缀和
因为块与块之间按原序排列,块内的前缀和又保持了元素的相对次序,所以最终顺序与原序一致。两个 compaction shader 在 CompactVisibleInstances.usf(:35、:109),对应 C++ 类 FCalculateCompactBlockInstanceOffsetsCs(每组 512 线程,一组处理一个 draw 的全部块,用循环加组内前缀和摊平)与 FCompactVisibleInstancesCs(每组 64 线程,一组一块,最多循环 NumViews 轮),分别在 InstanceCullingContext.cpp:437 和 :464。
10.3 代价
保序是按 draw 选择性开启的(Payload.CompactionDataIndex != 0xFFFFFFFF 才走压缩分支),普通不透明 draw 不受影响。但只要开启了保序能力(IsInstanceOrderPreservationAllowed,InstanceCullingContext.cpp:71:非移动端且 r.InstanceCulling.AllowInstanceOrderPreservation=1),deferred 路径就会多声明两个 pass 和两块临时缓冲(InstanceCulling.Compaction.TempInstanceIdsBuffer、InstanceCulling.Compaction.BlockInstanceCounts)。没有保序需求时,这两个 pass 的 dispatch 线程组数为 0、lambda 不会执行,但资源转换(barrier)裁不掉,代码里为此留着 TODO(InstanceCullingContext.cpp:1122、:1263)。保序 draw 的可见实例还要多一次全量读写临时缓冲,所以它是为半透明等确有需求的场景准备的。
十一、结果如何被消费:Indirect Draw 与顶点着色器
剔除结果——DrawIndirectArgsBuffer、InstanceIdOffsetBuffer、InstanceIdsBuffer——在绘制阶段被三个环节用上。
11.1 提交:SubmitDrawCommands
FInstanceCullingContext::SubmitDrawCommands(InstanceCullingContext.cpp:1727)在并行命令列表任务里逐 MDC 调用。每个 MDC 有一个 FMeshDrawCommandInfo(SetupDrawCommands 阶段填好):
- 若
bUseIndirect:IndirectArgsByteOffset = OverrideArgs.IndirectArgsByteOffset + DrawCommandInfo.IndirectArgsOffsetOrNumInstances——前者是该 pass 在合并 buffer 中的段起点(§7.3 回写的那个偏移),后者是该 draw 在 pass 内的位置,最终调用DrawIndexedPrimitiveIndirect(IndexBuffer, IndirectArgsBuffer, 偏移)(MeshPassProcessor.cpp:1362); - 否则(普通单实例 UnCulled draw):
InstanceFactor乘上 CPU 已知的合并数量,走普通的DrawIndexedPrimitive。
11.2 InstanceIdOffset 是怎么送到顶点着色器的
每个 draw 需要告诉顶点着色器:“我的实例 ID 从 InstanceIdsBuffer 的哪个位置开始”。这个偏移没有用 StartInstanceLocation,而是作为一条步长为 0 的顶点流传入:
-
InstanceIdOffsetBuffer每个 draw 一个uint,被绑定成顶点流。起点PrimitiveIdOffset = OverrideArgs.InstanceDataByteOffset + DrawCommandInfo.InstanceDataByteOffset(也就是 draw 序号 × 4 字节)在SubmitDrawCommands里算出(InstanceCullingContext.cpp:1784),在SubmitDrawBegin里作为流的起点绑定(MeshPassProcessor.cpp:1317); -
顶点元素声明在
LocalVertexFactory.cpp:441:Elements.Add(FVertexElement(StreamIndex, 0, VET_UInt, 13, 0, true)); // 属性 13,Stride = 0,按实例步进步长为 0 意味着同一个 draw 里所有实例读到的是同一个值——即该 draw 的输出基址。
❓ 不用 StartInstanceLocation,大概是因为 D3D 系 API 里 SV_InstanceID 不含起始实例偏移,各 RHI 上行为不一致,用一条顶点流显式传递最稳。
11.3 顶点着色器里的三次间接寻址
GetSceneDataIntermediates(InstanceIdOffset, DrawInstanceId)(SceneData.ush:1346)是所有支持 GPUScene 的顶点工厂的入口。引擎注释说明:InstanceIdOffset 是 instance step rate 为 0 的顶点流,对所有实例恒定;DrawInstanceId 是当前 draw 内的 SV_InstanceID。
Intermediates.InstanceIdLoadIndex = InstanceIdOffset + DrawInstanceId;
...
const uint PackedId = InstanceCulling.InstanceIdsBuffer[InstanceIdOffset + DrawInstanceId];
UnpackInstanceCullingOutput(PackedId, Intermediates.InstanceId, Intermediates.ViewIndex, Intermediates.CullingFlags);
...
Intermediates.InstanceData = GetInstanceSceneData(Intermediates.InstanceId);
Intermediates.PrimitiveId = Intermediates.InstanceData.PrimitiveId;
Intermediates.Primitive = GetPrimitiveData(Intermediates.PrimitiveId);三步是:InstanceIdOffset + SV_InstanceID → 查 InstanceIdsBuffer 得到打包 ID → 解包出 InstanceId / ViewIndex / CullingFlags → 用 InstanceId 到 GPUScene 取实例数据,再取图元数据。没有任何”逐实例的顶点数据”上传,绘制阶段的实例数据全部来自常驻的 GPUScene。
其中 ViewIndex 让多视图 pass 能选择渲染目标层,比如单 pass 点光源阴影选立方体的哪个面(ShadowDepthVertexShader.usf:250:LayerIndex = bUseGpuSceneInstancing ? VertexFactoryGetViewIndex(VFIntermediates) : LayerId);CullingFlags 则是 §8.3 里那个”是否计算 WPO”的位。
对于动态 draw pass(DrawDynamicMeshPassPrivate 等),源码里有一个显式标注 GPUCULL_TODO 的临时方案:顶点流的值最高位被置 1 时(VF_TREAT_INSTANCE_ID_OFFSET_AS_PRIMITIVE_ID_FLAG),它被当作图元 ID 而不是实例 ID 偏移,跳过 InstanceIdsBuffer,要求 draw : 图元 : 实例 严格 1:1:1(SceneData.ush:1358)。
十二、其它使用者与变体
12.1 VSM 的非 Nanite 剔除:复用说明书,换一个消费者
Virtual Shadow Map 对非 Nanite 几何有自己的剔除 shader CullPerPageDrawCommandsCs(VirtualShadowMapArray.cpp:3765,shader 入口在 VirtualShadowMapBuildPerPageDrawCommands.usf:155):它对每个实例 × 每个 mip 判断”是否与某个需要渲染的页重叠”,并用 VSM 自己的 per-page HZB(本帧的)做遮挡。输出也与通用的 CullInstances 不同:先产出”(实例, 页) 对”的可见列表,再由 AllocateCommandInstanceOutputSpaceCs 和 OutputCommandInstanceListsCs(VirtualShadowMapArray.cpp:3852、:3890)两个 kernel 为每个 draw 分配空间并写出实例 ID 列表,同时通过 FInstanceCullingGlobalUniforms::PageInfoBuffer 给每一条记录附带页信息。
但它并没有另起一套 CPU 数据:VSM 的 pass 复用同样的 FInstanceCullingContext(取 IndirectArgs、DrawCommandDescs、InstanceIdOffsets、LoadBalancers[0]、TotalInstances,VirtualShadowMapArray.cpp:4686-4709),并且用一个本地的 FInstanceCullingMergedContext 把所有 VSM 阴影的 context 合并起来(VirtualShadowMapArray.cpp:4427,第二个构造参数 bInMustAddAllContexts = true)。带 VSM 的阴影 pass 把单实例模式设成 Generic(ShadowSetup.cpp:2690),所有工作项都在 LoadBalancers[0] 里。这正是”context 与具体剔除 shader 解耦”的体现:一份 draw + 实例区间的描述,可以被不同的 GPU 消费者处理。
12.2 立体渲染与多视图
- 立体(ISR):
InstanceCullingMode = Stereo,ViewIds里放两只眼,shader 用STEREO_CULLING_MODEpermutation 一个线程同时测两只眼(§8.2)。它不参与 deferred 合批(§7.5)。 - 多视图:点光源单 pass 阴影登记 6 个剔除视图(
ShadowSetup.cpp:2638-2657),一个 context 有 6 个ViewIds。此时单实例图元也要走 Generic(§5.3),输出里每条记录的ViewIndex指明它属于哪个面。VSM clipmap 则只登记最粗一级的视图,因为它覆盖了更细的各级,能保证剔除是保守的(ShadowSetup.cpp:2658-2669)。
12.3 动态图元
动态图元的实例 ID 需要 DynamicInstanceIdOffset(§5.5)晚绑定。此外它们不走 FetchInstanceCountFromScene(分支里有 check(!bIsDynamicPrimitive),InstanceCullingContext.cpp:1643),也没有 §5.4 的 CPU 层级预剔除信息——后者是按场景图元的持久索引登记的,每帧临时生成的动态图元不在其中。
12.4 移动端:UniformBufferView 路径
移动端(PlatformGPUSceneUsesUniformBufferView)走另一条数据路径:顶点着色器不从 InstanceIdsBuffer 取 ID 再回 GPUScene 取数,而是让剔除 shader 直接把实例(或图元)数据写进一块 float4 buffer(WriteDataUBO / InstanceIdsBufferOutMobile,BuildInstanceDrawCommands.usf:80),draw 时把这块 buffer 当 uniform buffer 用动态偏移绑定。为适应 UBO 大小限制,一个 draw 的实例过多时会被拆成多个 indirect draw(MaxGenericBatchSize,InstanceCullingContext.cpp:1509;FMeshDrawCommandInfo::NumBatches,SubmitDrawCommands 里逐 batch 再调 SubmitDrawEnd)。此路径不支持保序压缩。这些差异大多被封装在 GetInstanceDataStrideElements(InstanceCullingContext.cpp:122)、StepInstanceDataOffsetBytes(:148)之类的辅助函数里,其余部分默认讨论桌面路径。
十三、调试与排查
13.1 开关与默认值(UE 5.8)
| CVar | 默认 | 作用 |
|---|---|---|
r.CullInstances | 1 | 关闭后 shader 的 CULL_INSTANCES 维度为 0:管线仍运行、实例 ID 仍被写出,只是不再测可见性 |
r.InstanceCulling.OcclusionCull | 0(Preview) | 启用逐实例的上一帧 HZB 遮挡剔除(§9.5) |
r.InstanceCulling.OcclusionQueries | 0(Preview,实验) | 启用逐实例软件遮挡查询(§9.6) |
r.InstanceCulling.ForceInstanceCulling | 0 | 强制所有 draw(包括单实例)走 Generic 与间接绘制,方便验证剔除结果 |
r.InstanceCulling.AllowInstanceOrderPreservation | 1 | 是否允许 GPU 保序压缩(§10) |
r.InstanceCulling.AllowBatchedBuildRenderingCommands | 1 | 是否允许合批(§7);关闭后每个 pass 单独 dispatch,便于分 pass 抓帧 |
r.InstanceCulling.UseLoadBalancer | 1 | 逐实例遮挡查询的筛选 CS 是否借用 BasePass 的 Load Balancer 作为工作列表 |
r.HZBOcclusion | 0(代码初值) | 决定 bFurthestHZB 的条件之一(§9.5) |
r.MeshDrawCommands.DynamicInstancing | 1 | 不控制 GPUScene 路径上的合并(§5.2) |
r.MeshDrawCommands.ParallelPassSetup | 1 | mesh pass setup 是否并行 |
r.DeferredMeshPassSetupTaskSync | 1 | 把 setup 任务的同步点推迟到 RDG execute,增加重叠 |
r.InstancedStaticMeshes.FetchInstanceCountFromScene | 1 | ISM 从场景而不是 MDC 取实例数(§5.3) |
r.SceneCulling.HierarchicalCPUCulling | true | CPU 层级预剔除(§5.4) |
r.GPUScene.InstanceDataTileSizeLog2 | 12 | 实例数据的 tile 大小(§4.2),负数关闭平铺 |
r.MeshDrawCommands.Stats | 0 | 屏幕显示 MDC 统计,可见三角形数是 GPU 剔除之后的(通过 indirect args 回读得到) |
r.MeshDrawCommands.LogDynamicInstancingStats | 0 | 下一帧打印 dynamic instancing 的合并统计 |
r.ShowMaterialDrawEvents | 0 | 给每个 draw 打带材质名的事件(§13.3) |
要观察 instance 级遮挡剔除的效果,需要同时满足:r.CullInstances=1、r.InstanceCulling.OcclusionCull=1,并且上一帧确实生成、提取了 HZB(§9.5)。
❗ ViewDistanceScale 目前是在图元上传 GPUScene 时烘进数据里的,CPU 侧层级预剔除的最大绘制距离测试(SceneCullingRenderer.cpp:398-400)要与它保持一致。运行时改了缩放,需要图元重新上传才会生效。
13.2 RenderDoc / RDG 里看什么
RDG 事件名:BuildRenderingCommandsDeferred(Culling=On)(合批路径)或 BuildRenderingCommands(Culling=On)(单 pass 路径)下面依次是:ClearIndirectArgInstanceCount、CullInstances(UnCulled). Bin 0、CullInstances(Generic). Bin 1..N、Instance Compaction Phase 1 / 2(单 pass 路径下 CullInstances 的 pass 名没有 . Bin N 后缀)。这两个 scope 各有一个同名的 GPU stat(InstanceCullingContext.cpp:68-69),stat gpu 里可以直接看到耗时。
缓冲名:InstanceCulling.InstanceIdsBuffer、InstanceCulling.DrawIndirectArgsBuffer、InstanceCulling.InstanceIdOffsetBuffer、InstanceCulling.DrawCommandDescs、InstanceCulling.PayloadData、InstanceCulling.ViewIds、InstanceCulling.BatchInfos、InstanceCulling.BatchInds、InstanceCullingLoadBalancer.Batches / Items,保序还有 InstanceCulling.Compaction.*。
一个实用的排查顺序(“某个实例为什么没画出来 / 为什么多画了”)。合批时这些 buffer 是所有 pass 的拼接,下标都是全局的,先要用该 draw 事件里的 indirect args 偏移定位到自己的那一项:
- 在
InstanceCulling.DrawIndirectArgsBuffer里找到对应 draw(每 5 个uint,第 2 个是InstanceCount)。InstanceCount为 0:整个 draw 一个实例都没留下,直接看第 3 步;不为 0:进入第 2 步核对留下的是不是你要找的实例; - 在
InstanceIdOffsetBuffer里查该 draw 序号对应的起点,看InstanceIdsBuffer该区间前InstanceCount个值里有没有你要找的InstanceId(注意低 24 位是 ID,高位是 flag 和 view)。有:剔除没问题,问题在绘制阶段(材质 / PSO);没有:看第 3 步; - 到
ItemBuffer里看 item 是否覆盖了这个实例(InstanceDataOffset_NumInstances解包,§6.4)。没有:问题在 CPU 侧——图元没进这个 MDC、被 §5.4 的层级预剔除丢掉、或 LOD 范围不含它;有:GPU 判定把它剔掉了; - 想判断具体是哪一级把它剔掉,可以逐个关闭对应开关,或用
r.InstanceCulling.ForceInstanceCulling,并在IsInstanceVisible(§9.1)里按顺序检查:距离 / 屏幕尺寸(LOD 范围)/ 视锥 / HZB / 遮挡查询位。
13.3 几个容易困惑的现象
- ❗ 绘制事件名里的
(N instances)不是真实实例数。打开r.ShowMaterialDrawEvents后,SubmitDrawCommands(InstanceCullingContext.cpp:1787)给每个 draw 打的事件名是材质名 资源名 (N instances),其中 N 是MeshDrawCommand->NumInstances * InstanceFactor,这是 CPU 已知的值:ISM 被刻意改成 1(§5.3);HISM 是”run 的个数”(HierarchicalInstancedStaticMesh.cpp:1343:MeshBatchElement.NumInstances = RunArray.Num() / 2)。所以植被 draw 的事件名常常显示 1 个实例,而真实数量在 indirect args 里——这就是抓帧时常见的”事件名里 instance 数为 1,实际绘制的却不止 1 个”的原因。 InstanceIdsBuffer里 0 不代表”不可见”(§8.5)。- 同一批实例在 PrePass 和 BasePass 各被剔除一次。两个 pass 的 draw 划分(PSO、材质)不同,实例到 draw 的映射就不同,结果不能共享。合批只省了 dispatch 和 buffer 的开销,没省重复的剔除运算。这是 GPU 剔除成本随 pass 数量线性增长的来源。
13.4 成本模型与可用的抓手
⚠️ 从前面的流程可以推出一个大致的成本模型:
- GPU 成本 ≈ Σ 各 pass(Generic 实例数 × 视图数)× 单实例判定成本。单实例判定要读 3~4 个 float4 的实例数据、可能还有 payload,再做包围盒的 8 角点投影,开了遮挡还有 4 次 HZB gather,整体偏访存受限。UnCulled 单实例几乎只写一个 ID,便宜得多;
- CPU 成本主要在
SetupDrawCommands(并行任务)和MergeBatches(渲染线程,近乎 memcpy),都与 item 数而不是实例数成正比; - 输出缓冲的显存与”全部实例 × 视图数”成正比,与可见数无关。
对应的优化抓手,也都能在代码里找到落脚点:
- 减少送进 Generic 的实例数:让 ISM 具备预计算空间哈希,启用 CPU 层级预剔除(§5.4),整块 cell 被丢掉就不会生成 item;合理设置实例的最大绘制距离,使远处的 cell 在 CPU 端就被
MaxInstanceDrawDistance测试丢弃(SceneCullingRenderer.cpp:400); - 减少视图数与 pass 数:多视图 pass 的成本按视图数放大(立方体阴影是 6 倍,§5.3),阴影 pass 越多、每个 pass 的实例越多,剔除成本越高;
- 让 draw 合并得更好:同网格同材质的图元靠
StateBucketId合并成一个 draw(§5.2),能减少 indirect args 与工作项的个数; - 观察手段:
stat gpu里的BuildRenderingCommandsDeferred(§13.2);开启r.MeshDrawCommands.Stats触发统计收集后,stat culling里的InstanceCulling Indirect Rendered Instances / Primitives / Vertices(MeshDrawCommandStats.cpp:29-31)是 GPU 剔除之后的数量(来自 indirect args 的异步回读,会滞后几帧);再到 RenderDoc 里对照每个 draw 的InstanceCount与它预留的区间大小,能直接算出剔除率。
十四、设计取舍回顾
- CPU 描述、GPU 执行,描述要足够小。说明书是”每个 draw 一条 + 每个 item 8 字节”,item 的数量约为”实例数 / 64 + 实例区间数”,而不是逐实例的数据;因此可以每帧重建,而不需要缓存。
- 用 indirect draw 承载”数量未知”。draw call 总是被录制,
InstanceCount由 GPU 填;代价是每个 draw 要按最坏情况预留输出空间,InstanceIdsBuffer的大小与全部实例数成正比而不是与可见数成正比。 - 只传 ID,不传数据。输出是 4 字节的打包 ID(ID + view + flag),实例数据留在常驻 GPUScene,绘制阶段间接取数。剔除因此可以在实例数据完全不动的情况下反复进行,GPUScene 只增量更新。
- 负载均衡用”连续序列 + 定长切分”。利用”一个图元的实例连续”这一存储约定,让工作项只是
(offset, count);CPU 贪心切分、GPU 组内做一次前缀最大值,就得到既满载又不需要全局查表的映射。 - 合并用”只追加,不改写”。packed 数据里存相对值,绝对偏移放进每个 context 的
BatchInfo,让 GPU 在解码时叠加,使得跨 pass 合并近乎纯 memcpy。 - 借助 RDG 的延迟求值解决”合并需要等待所有 pass”的时序问题。缓冲大小与 dispatch 尺寸都以回调传入,在真正需要时才触发合并;
FInstanceCullingDrawParams因此需要 RDG 生命周期以便回写偏移。 - 便宜的先做,昂贵的后做,并且分级预筛。单实例图元根本不做 GPU 剔除;ISM 先用 CPU 层级 cell 粗筛,再由 GPU 精筛;GPU 内部按”有效性 → 距离 → 屏幕尺寸 → 视锥 → HZB → 查询”的顺序短路。
- 复用 Nanite 的视图结构与包围盒剔除函数。非 Nanite 与 Nanite 在距离、WPO 关闭、clip plane、屏幕尺寸等语义上完全一致,且剔除代码只有一份。
- 让剔除结果携带”质量档位”。输出里的
EVALUATE_WPO位把剔除阶段已经算好的距离信息传给顶点着色器,零成本地关闭远处实例的 WPO。 - 把 LOD 选择细化到每个实例。CPU 只决定”可能用到哪几个 LOD”(LOD 范围),并为每个 LOD 生成 MDC;GPU 按屏幕尺寸让每个实例只在属于它的 LOD 里存活。
- 用遮挡精度换取批处理。遮挡用上一帧 HZB,使得所有 pass 的剔除可以在帧首一次完成;代价是一帧延迟与
OcclusionCull默认关闭。需要更精确时,由实验性的逐实例遮挡查询做跨帧的补偿。 - 说明书与消费者解耦。同一份
FInstanceCullingContext既能被通用的CullInstances处理,也能被 VSM 的 per-page 剔除、逐实例遮挡查询复用。
十五、一页速记
15.1 Load Balancer
| 结构 | 位域 |
|---|---|
FPackedBatch.FirstItem_NumItems | 高 25 位 FirstItem,低 7 位 NumItems |
FPackedItem.InstanceDataOffset_NumInstances | 高 25 位 InstanceDataOffset,低 7 位 NumInstances(0–64) |
FPackedItem.Payload_BatchPrefixOffset | 高 26 位 Payload,低 6 位 BatchPrefixOffset(0–63) |
| Payload(普通) | bit 0 = 保序(0),bit 1 = 动态偏移,bit 2+ = IndirectArgsOffset |
| Payload(保序) | bit 0 = 保序(1),bit 1 = 动态偏移,bit 2+ = PayloadData 数组下标 |
15.2 剔除输出与相关标志
| 名称 | 内容 |
|---|---|
PackInstanceCullingOutput | bit 0–23 InstanceId,bit 24–27 CullingFlags,bit 28–31 ViewIndex |
INSTANCE_CULLING_FLAG_EVALUATE_WPO | CullingFlags 的 bit 0 |
FDrawCommandDesc(x 分量) | bit 0 = 使用 WPO,bit 1 = 总是求值 WPO,bit 2–5 = LOD 序号,bit 6–18 = MinScreenSize(3.10 定点,13 位),bit 19–31 = MaxScreenSize(同) |
FDrawCommandDesc(y 分量) | DynamicMeshBoundsIndex |
FContextBatchInfoPacked.NumViewIds_Flags | 高 30 位 NumViewIds,bit 0 = 允许遮挡剔除,bit 1 = 只画选中 |
Indirect args(5 个 uint32) | IndexCount, InstanceCount, StartIndex, BaseVertex, StartInstance;GPU 只累加第 1 项 |
15.3 GPUScene 实例数据
| 名称 | 内容 |
|---|---|
InstanceId | 24 bit(MAX_INSTANCE_ID = 1 << 24) |
| 实例 flag | 12 bit 字段,已用 11 个:DETERMINANT_SIGN, HAS_RANDOM, HAS_CUSTOM_DATA, HAS_DYNAMIC_DATA, HAS_SKINNING_DATA, HAS_LIGHTSHADOW_UV_BIAS, HAS_HIERARCHY_OFFSET, HAS_LOCAL_BOUNDS, HAS_PAYLOAD_EXTENSION, HAS_EDITOR_DATA, HIDDEN |
Data[0] | x = flag(12) 与 PrimitiveId(20),y = 自定义数据个数(8) 与 RelativeId(24),z = LastUpdateFrame,w = RandomID |
| 寻址 | TileStride * (Id >> Log2) + (ArrayIndex << Log2) + (Id & Mask),默认 tile = 4096 实例 |
十六、参考链接
官方文档
🔗 Mesh Drawing Pipeline in Unreal Engine — FMeshBatch → FMeshDrawCommand 的转换、缓存与提交,GPU Instance Culling 就嫁接在这条管线的后半段
🔗 Render Dependency Graph in Unreal Engine — RDG 的构建期 / 执行期拆分与延迟执行模型,合并剔除 pass 依赖的正是这套时序
🔗 FMeshDrawCommand API 参考 — SubmitDrawBegin 等提交接口的 API 页
演讲与文章
🔗 GPU-Driven Rendering Pipelines(Haar & Aaltonen,SIGGRAPH 2015) — GPU 驱动渲染管线的经典报告:按材质的实例合批、mesh cluster 剔除、indirect / multidraw
🔗 Optimizing the Graphics Pipeline with Compute(Wihlidal,GDC 2016) — 用 compute 在图形管线之前剔除几何的做法与优化
🔗 A Deep Dive into Nanite Virtualized Geometry(Karis 等,SIGGRAPH 2021) — GPUScene 常驻、逐视图 GPU instance culling 以及 Nanite 两遍遮挡剔除的设计出处
🔗 Hierarchical-Z map based occlusion culling(RasterGrid) — HZB 遮挡剔除的基本思路:用深度金字塔的某一级 mip 做保守深度比较
🔗 GPU Gems 3 第 39 章:Parallel Prefix Sum (Scan) with CUDA — 并行前缀和的入门讲解,对应 Load Balancer 的 PrefixMax 与保序压缩里的组内前缀和
引擎源码索引(UE 5.8,相对路径)
| 主题 | 相对路径 | 关键符号 |
|---|---|---|
| context 类与枚举 | Engine/Source/Runtime/Renderer/Public/InstanceCulling/InstanceCullingContext.h | FInstanceCullingContext · FInstanceCullingDrawParams (:33) · FCompactionData (:300) |
SetupDrawCommands / 提交 / 合批声明 / compaction 类 | Engine/Source/Runtime/Renderer/Private/InstanceCulling/InstanceCullingContext.cpp | SetupDrawCommands (:1453) · BuildRenderingCommandsInternal (:695) · CreateDeferredContext (:1037) · SubmitDrawCommands (:1727) · FCalculateCompactBlockInstanceOffsetsCs (:437) |
| 合并 | Engine/Source/Runtime/Renderer/Private/InstanceCulling/InstanceCullingMergedContext.h、InstanceCullingMergedContext.cpp | MergeBatches (:30) · AddBatch (:162) · FContextBatchInfoPacked (.h:24) |
管理器与 BeginDeferredCulling | Engine/Source/Runtime/Renderer/Private/InstanceCulling/InstanceCullingManager.h、InstanceCullingManager.cpp | GetBinIndex (:55) · BeginDeferredCulling (:99) |
| Load Balancer(CPU) | Engine/Source/Runtime/Renderer/Private/InstanceCulling/InstanceCullingLoadBalancer.h | Add (:134) · 位域 (:33-65) |
| Load Balancer / 通用解码(GPU) | Engine/Shaders/Private/InstanceCulling/InstanceCullingLoadBalancer.ush、InstanceCullingSetup.ush、InstanceCullingCommon.ush | InstanceCullingLoadBalancer_Setup (:164) · LoadInstanceCullingSetup · LoadBatchInfo |
| 共享常量 | Engine/Shaders/Shared/InstanceCullingDefinitions.h | Payload 位掩码 · INSTANCE_CULLING_FLAGS_* |
| 剔除 shader | Engine/Shaders/Private/InstanceCulling/BuildInstanceDrawCommands.usf | IsInstanceVisible (:117) · InstanceCullBuildInstanceIdBufferCS (:243) |
| 保序压缩 | Engine/Shaders/Private/InstanceCulling/CompactVisibleInstances.usf、InstanceCompactionCommon.ush | CalculateCompactBlockInstanceOffsetsCS (:35) · CompactVisibleInstances (:109) |
| 逐实例遮挡查询 | Engine/Source/Runtime/Renderer/Private/InstanceCulling/InstanceCullingOcclusionQuery.h、InstanceCullingOcclusionQuery.cpp;Engine/Shaders/Private/InstanceCulling/InstanceCullingOcclusionQuery.usf | FInstanceCullingOcclusionQueryRenderer::Render (.cpp:550) · MainCS (.usf:154) |
| 包围盒剔除 / HZB | Engine/Shaders/Private/Nanite/NaniteCullingCommon.ush、NaniteHZBCull.ush | FBoxCull · BoxCullFrustumPerspective (:444) · GetScreenRect (:71) |
| GPUScene 数据 | Engine/Source/Runtime/Renderer/Private/GPUScene.h、GPUScene.cpp;Engine/Shaders/Private/SceneData.ush;Engine/Shaders/Shared/SceneDefinitions.h;Engine/Source/Runtime/Engine/Public/InstanceUniformShaderParameters.h | AllocateInstanceSceneDataSlots · CalcInstanceDataIndex · PackInstanceCullingOutput · FInstanceSceneShaderData::BuildInternal |
| culling view 数据 | Engine/Source/Runtime/Renderer/Private/ViewData.h、ViewData.cpp;Engine/Shaders/Private/ViewData.ush;Engine/Source/Runtime/Renderer/Private/Nanite/NaniteShared.cpp | RegisterPrimaryView (ViewData.cpp:82) · SetCullingViewOverrides (NaniteShared.cpp:205) |
| mesh pass setup | Engine/Source/Runtime/Renderer/Private/MeshDrawCommands.cpp、SceneRendering.cpp、SceneVisibility.cpp | DispatchPassSetup (MeshDrawCommands.cpp:1373) · SetupMeshPass (SceneRendering.cpp:5010) · SetupMeshPasses (SceneVisibility.cpp:4728) |
| MDC 数据与提交 | Engine/Source/Runtime/Renderer/Public/MeshPassProcessor.h、Engine/Source/Runtime/Renderer/Private/MeshPassProcessor.cpp | SubmitDrawBegin (.cpp:1248) · SubmitDrawEnd (.cpp:1332) · FMeshDrawCommandCullingPayload (.h:1672) |
| CPU 层级预剔除 | Engine/Source/Runtime/Renderer/Private/SceneCulling/;Engine/Source/Runtime/Engine/Private/InstanceData/InstanceDataHelpers.cpp | FSceneCulling · ComputeCulling (SceneCullingRenderer.cpp:370) · BuildSpatialHashData (InstanceDataHelpers.cpp:51) |
| 每帧调度 | Engine/Source/Runtime/Renderer/Private/DeferredShadingRenderer.cpp;Engine/Source/Runtime/Renderer/Private/RendererScene.cpp | FDeferredShadingSceneRenderer::Render (:1825) · BeginDeferredCulling 调用 (:2272 / :3945) · FScene::Update (RendererScene.cpp:5534) |
| VSM 的非 Nanite 剔除 | Engine/Source/Runtime/Renderer/Private/VirtualShadowMaps/VirtualShadowMapArray.cpp;Engine/Shaders/Private/VirtualShadowMaps/VirtualShadowMapBuildPerPageDrawCommands.usf | FCullPerPageDrawCommandsCs (.cpp:3765) · CullPerPageDrawCommandsCs (.usf:155) |